OCI 무료 자원을 노드 3개로 나눠 Swarm을 운영해 보니
오라클 클라우드의 Always Free 자원(ARM 4코어, 메모리 24GB)을 노드 세 개로 나눠 Docker Swarm 클러스터를 운영했습니다. 어떻게 구성했고, Kubernetes와 비교해 어디가 편하고 어디를 직접 챙겨야 했는지 항목별로 정리했습니다.
목차
앞 글에서 Compose, Docker Swarm, Kubernetes가 개념적으로 어떻게 다른지 봤습니다. 이 글은 그 Swarm을 실제로 운영해 본 기록이에요.
2019년부터 사이드 프로젝트로 대학 강의평가 사이트를 운영하고 있습니다. 돈을 거의 들이지 않고 돌리고 싶어서 무료로 쓸 수 있는 곳을 찾아 옮겨 다니다 오라클 클라우드(OCI)에 자리를 잡았고, 거기서 받은 무료 자원을 노드 세 개로 나눠 Swarm 클러스터를 꾸렸습니다. 지금은 Kubernetes로 옮겼지만, Swarm은 거쳐 가기 꽤 좋은 단계였어요.
무료 자원을 찾아 옮겨 다니며
Heroku에서 시작해 AWS 프리티어, NCP(네이버 클라우드)를 거쳐 OCI까지 왔습니다. AWS 프리티어는 쓸 수 있는 기간이 정해져 있었고, NCP는 쓸 수 있던 자원의 정책이 바뀌면서 웹 서비스를 계속 올려 둘 수 없게 됐어요.
네 번 이사하면서 남은 교훈은 하나입니다.
- 클라우드마다 다른 것: 배포하는 방법(Heroku는 git push, VM은 직접 세팅), 서버 기본 설정, 네트워크와 방화벽 규칙, 요금 구조. 옮길 때마다 새로 배워야 합니다.
- 어디서나 같은 것: 컨테이너 이미지와 compose 파일. 리눅스 서버에 Docker만 있으면 같은 파일로 같은 서비스가 뜹니다. 컨테이너가 커널 기능의 조합이라, 리눅스 커널이 있는 곳이면 어디든 가거든요.
이미지와 compose 파일만 챙기면 이삿짐이 가벼워집니다.
무료 조건은 자주 바뀐다는 것도 알아 두면 좋아요. Heroku의 무료 플랜은 2022년 11월에 없어졌고, AWS는 2025년 7월 15일부터 새 계정에 12개월 무료 대신 최대 200달러 크레딧과 6개월짜리 무료 플랜을 줍니다.
OCI Always Free: 자원을 나눠 노드 여러 개로
OCI의 Always Free는 기간 제한 없이 쓸 수 있고, 양이 꽤 큽니다.
| 항목 | 무료 한도 |
|---|---|
| CPU | ARM(Ampere A1) 4 OCPU. 정확히는 한 달 3,000 OCPU시간 |
| 메모리 | 24GB. 정확히는 한 달 18,000GB시간 |
| 블록 스토리지 | 200GB (서버 부팅 디스크도 여기에 포함) |
| 나가는 트래픽 | 한 달 10TB |
핵심은 이 4코어·24GB를 서버 한 대로 써도 되고, 여러 대(최대 4대)로 나눠 써도 된다는 점입니다. 저는 VM 세 대로 나눠 노드 3개짜리 클러스터를 만들었어요. 서버가 여러 대 생기니 앞 글에서 본 "어느 서버에 띄우지?", "죽으면 누가 다시 띄우지?" 같은 질문이 바로 제 문제가 됐습니다.
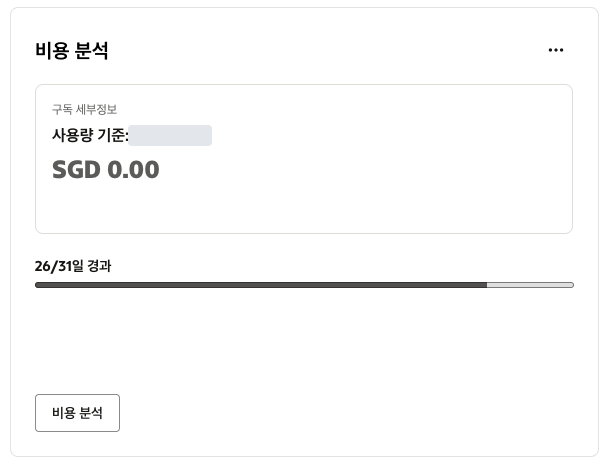
실제로 이렇게 운영하면서 받은 청구 금액은 0원(싱가포르 달러 0.00)이었습니다.
따라 해 보기 전에
- ARM CPU입니다. 이미지가 ARM(arm64)용으로도 나와 있어야 해요. 직접 만드는 이미지는
docker buildx build --platform linux/amd64,linux/arm64처럼 두 아키텍처로 빌드해 두면 편합니다.- 인기 리전은 ARM 서버 자리가 모자라 만들기 어려울 때가 있습니다.
- Always Free 계정은 오래 놀고 있는 인스턴스를 회수할 수 있습니다. 계정을 종량제(Pay As You Go)로 올리면 무료 한도 안에서는 여전히 0원이고, 회수 대상에서도 빠져요. 유료로 올려야 무료 자원을 쓸 수 있는 건 아니고, 계속 켜 두려면 올리는 게 마음 편하다는 쪽에 가깝습니다.
- 조건은 바뀔 수 있으니 가입 전에 공식 문서를 꼭 확인하세요.
왜 Kubernetes가 아니라 Swarm이었나
서버가 생겼으니 업계 표준인 Kubernetes를 올리면 됐을 텐데, 혼자서 사이드 프로젝트를 운영하기엔 너무 어렵고 복잡했습니다. 배워야 할 리소스 종류도 많고, 설치하고 유지하는 것 자체가 일이었어요. 그래서 단계를 나눴습니다.
- 지금 쓰는 서버 한 대에서
docker swarm init으로 노드 1개짜리 Swarm을 만든다. - 다른 서버에서
docker swarm join으로 붙여 노드 3개로 늘린다. - 규모가 커지고 정말 필요해지면 그때 Kubernetes로 간다.
Swarm을 고른 이유는 앞 글에서 본 장점 그대로였어요. Docker에 이미 들어 있어서 설치할 게 없고, docker service, docker stack은 아는 Docker 명령의 연장이고, 쓰던 compose 파일에 deploy 블록만 더하면 클러스터에 올라갔습니다.
실제 구성
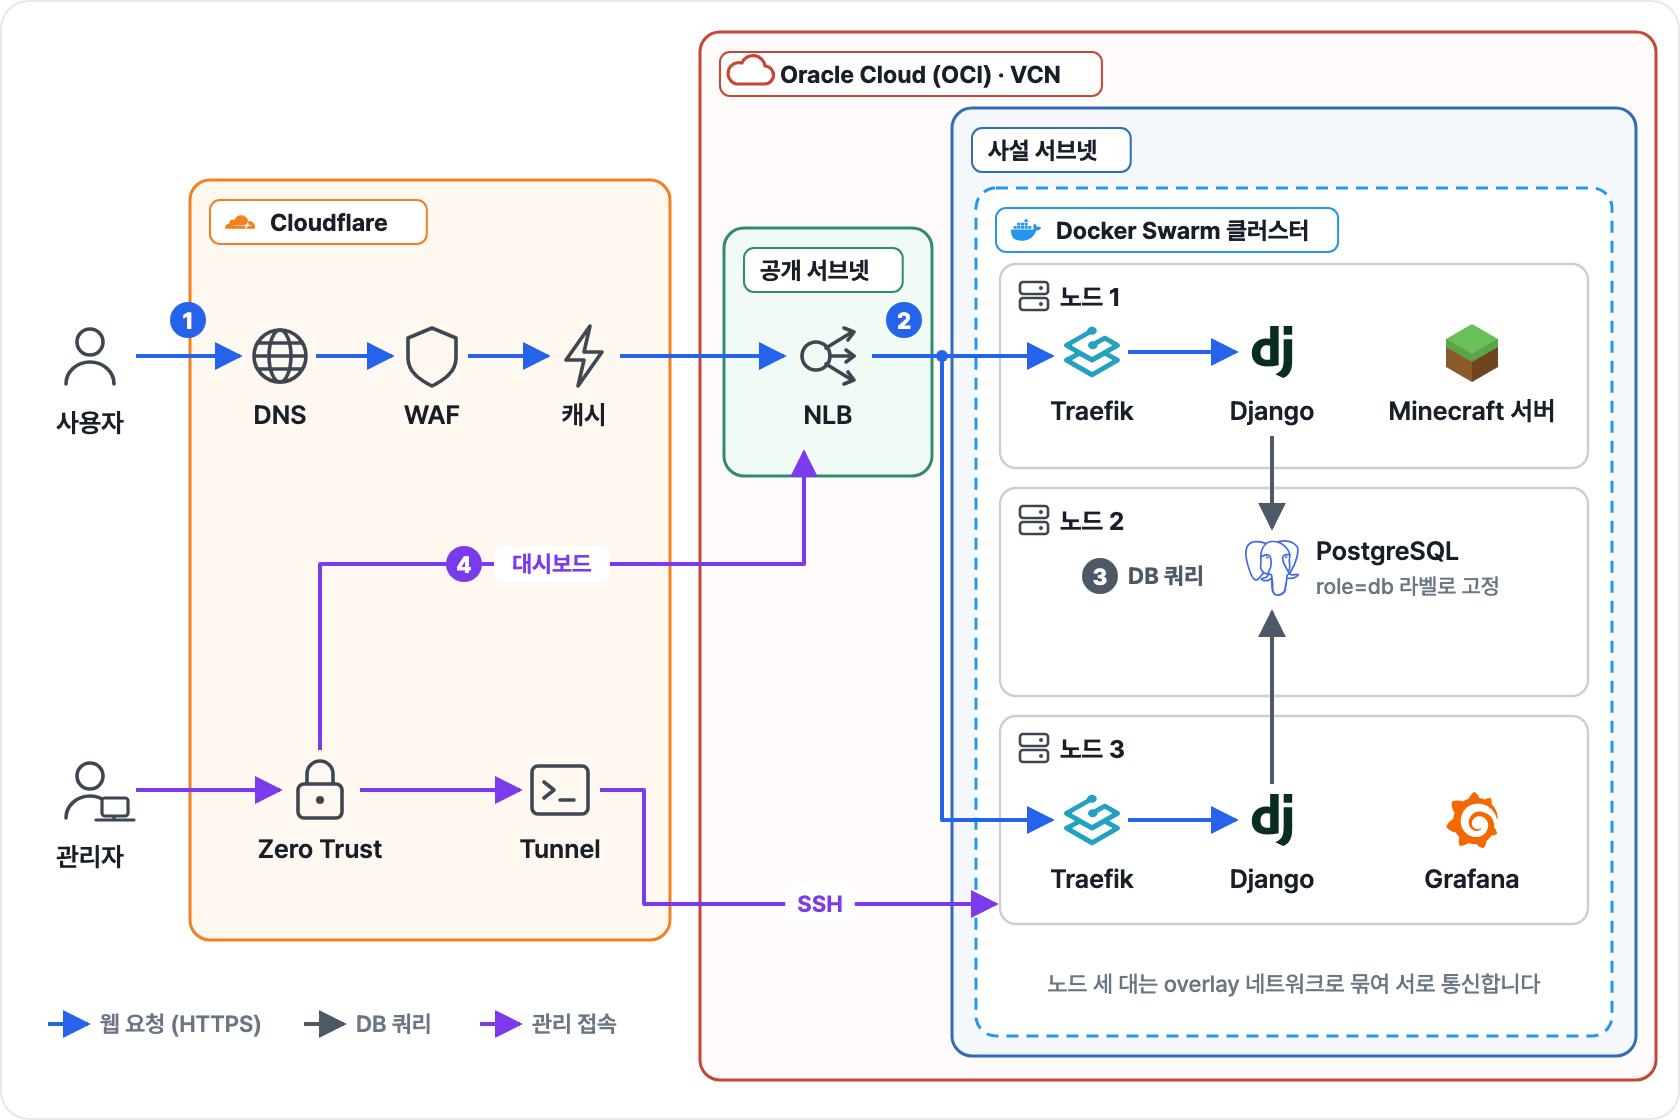
번호를 따라 요청 하나를 따라가 보면 이렇습니다.
- 사용자가 사이트 주소로 들어오면 먼저 Cloudflare를 거칩니다. DNS는 요청이 지나가는 곳이라기보다 "이 도메인은 Cloudflare 주소로 가라"고 알려 주는 곳이에요. 그렇게 Cloudflare로 온 요청은 공격 차단(WAF)과 캐시를 지나고, 통과한 것만 OCI의 로드밸런서(NLB)로 옵니다. NLB는 공개 서브넷에 있고, 노드 세 대는 밖에서 바로 들어올 수 없는 사설 서브넷에 있어요.
- NLB가 노드 1과 노드 3의 Traefik으로 요청을 넘깁니다. Traefik은 요청의 도메인을 보고 알맞은 서비스로 보내 주는 프록시예요. Django 서비스는 레플리카 2개로 노드 1과 3에 하나씩 떠 있어서 한 대가 꺼져도 사이트는 돕니다. 그림에서는 같은 노드의 Django로 이어 그렸지만, 노드들이 overlay 네트워크로 묶여 있어서 Traefik은 다른 노드의 Django로도 요청을 보낼 수 있어요.
- Django는 노드 2의 PostgreSQL에 붙습니다. DB는
role=db라벨로 노드 2에 고정해 뒀어요. 아래 stack 파일에서 볼게요. - 관리용 접속은 Cloudflare Zero Trust로 로그인한 사람만 들어옵니다. Grafana 대시보드는 로그인을 거친 뒤 NLB를 지나 노드 3의 Grafana로 가고, SSH는 Cloudflare Tunnel로만 들어와요. Tunnel은 클러스터 안에서 도는 cloudflared가 Cloudflare 쪽으로 먼저 연결을 열어 두는 방식이라, 서버의 SSH 포트를 인터넷에 열어 둘 필요가 없습니다.
같은 클러스터에 친구들과 할 마인크래프트 서버도 함께 띄웠습니다. 서비스를 추가할 때마다 stack 파일 하나를 더 배포하면 됐어요.
이럴 때 오케스트레이터의 편함이 바로 느껴집니다. 마인크래프트 서버는 자원을 많이 먹어서 노드 1에 CPU와 메모리를 더 크게 나눠 줬는데, 그래도 노드 1이 빠듯해지면 파일에서 배치 조건만 바꿔 다시 배포하면 됐거든요.
deploy:
  placement:
    constraints:
      - node.hostname == node3    # 이 서비스는 node3에만
서버에 들어가 컨테이너를 옮기는 게 아니라, "어디에 있어야 하는지"만 고쳐 적으면 Swarm이 맞춰 줍니다. 레플리카 수를 줄여서 노드마다 덜 띄우게 할 수도 있고요.
실제 stack 파일
DB(PostgreSQL) 서비스의 stack 파일입니다. 앞부분은 compose 파일과 똑같아요.
# postgresql.yml
services:
  postgresql:
    image: postgres:18
    networks: [backend]
    secrets: [pg_user, pg_password]
    volumes:
      - db-data:/var/lib/postgresql
    ports:
      - target: 5432
        published: 5432
        mode: host
    deploy:
      replicas: 1
      placement:
        constraints:
          - node.labels.role == db
      resources:
        limits:
          cpus: "1.0"
          memory: 4G
      restart_policy:
        condition: any
networks, volumes 같은 최상위 정의는 줄였습니다. 하나씩 보면 이렇습니다.
secrets: 비밀번호 같은 값을 Swarm secret으로 만들어 두면, manager가 암호화해서 보관하고 컨테이너 안에는/run/secrets/아래 파일로만 넣어 줍니다. 환경변수에 비밀번호를 그대로 적지 않아도 돼요.ports의mode: host: 이 컨테이너가 떠 있는 노드에서만 5432를 엽니다. 기본값(ingress)은 모든 노드에서 열고 알아서 넘겨 주는 라우팅 메시인데, DB처럼 한 곳에만 있는 서비스는host로 두기도 합니다.placement.constraints:role=db라벨이 붙은 노드에만 띄웁니다. 라벨은docker node update --label-add role=db node2로 붙여요. DB 데이터가 그 노드의 디스크에 있으니 고정해 둔 겁니다.resources.limits: 지난 글에서 본 cgroup 한도입니다. 노드의cpu.max와memory.max에 그대로 적혀요.restart_policy: 어떤 이유로 끝나든 다시 띄웁니다.
같은 파일을 docker compose up -d로 올리면 서버 한 대에 뜨고, docker stack deploy -c postgresql.yml db로 올리면 클러스터에 뜹니다. compose를 쓰던 사람이 Swarm으로 넘어가기 쉬운 이유예요.
운영해 보니: Kubernetes와 항목별 비교
| Swarm | Kubernetes | |
|---|---|---|
| 선언 단위 | 파일 하나에 서비스·네트워크·볼륨·시크릿 | 리소스마다 (Deployment, Service, Ingress …) |
| 스케일링 | 레플리카 수를 직접 바꿈 | HPA, VPA, Cluster Autoscaler |
| 상태 저장 | Docker volume (노드 고정이나 NFS) | PV, PVC, StorageClass, CSI |
| L7 라우팅 | 표준 리소스 없음, 프록시를 서비스로 직접 | Ingress, Gateway API |
| 인증서 | 프록시가 노드 파일에 저장 | cert-manager가 클러스터 공용 Secret에 저장 |
| 보안 | 얇다: 노드 사이 포트 3개, 기본 상호 TLS | 두껍다: RBAC, NetworkPolicy, Namespace |
| 관측 | exporter와 대시보드를 직접 조립 | 표준 메트릭 + Helm 차트 |
| 배포 자동화 | Portainer, CI 스크립트 | Argo CD, Flux (GitOps) |
Swarm 칸이 짧은 건 기능이 적어서이기도 하고, 그만큼 단순해서이기도 합니다. 위에서부터 직접 부딪힌 이야기와 함께 볼게요.
스케일링: 손으로, 또는 자동으로
Swarm에서는 한 줄이면 개수가 바뀝니다.
docker service scale web=5
쉽지만 언제 늘릴지는 사람이 정합니다. 트래픽에 따라 자동으로 늘리고 줄이는 기능이 Swarm에는 없어서, 필요하면 CPU 지표를 보고 이 명령을 부르는 스크립트를 직접 짜야 해요.
Kubernetes에는 자동 확장이 세 단계로 있습니다. (Pod는 Swarm의 태스크처럼 레플리카 하나의 자리예요.)
| 이름 | 하는 일 |
|---|---|
| HPA | Pod 개수를 늘리고 줄임 (CPU 사용률 등 기준) |
| VPA | Pod 하나의 CPU·메모리 크기를 조정. 기본으로 들어 있지 않아 따로 설치 |
| Cluster Autoscaler | Pod를 놓을 자리가 없으면 **노드(서버)**를 추가 |
다만 노드를 자동으로 늘리려면 누군가 서버를 사 와야 합니다. 클라우드 API로 서버를 만들어야 하니 EKS나 GKE 같은 매니지드 서비스에서나 쉽게 되고, 직접 서버를 꾸린 클러스터라면 Kubernetes를 써도 이 부분은 만만치 않아요. Swarm에 이런 도구가 없는 건, 쓰는 사람이 적어서 도구가 없는 건지 도구가 없어서 쓰는 사람이 적은 건지 닭과 달걀 같은 문제이기도 합니다.
상태 저장: 볼륨은 노드에 남는다
Swarm을 처음 쓸 때 가장 놓치기 쉬운 부분입니다. docker volume으로 만든 볼륨은 기본적으로 그 노드의 디스크에 있어요. 태스크가 다른 노드로 옮겨 가면 볼륨은 따라가지 않습니다.
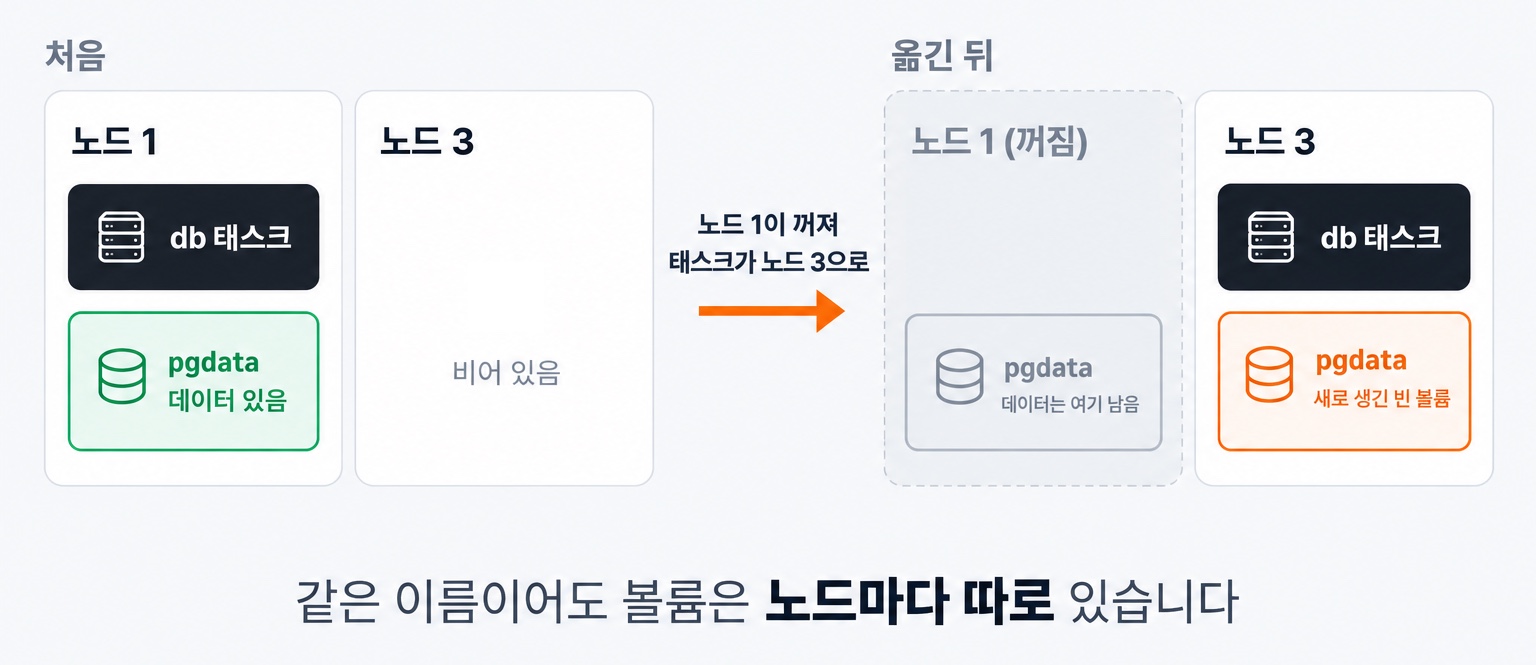
노드 3에는 같은 이름의 빈 볼륨이 새로 생기고, DB는 데이터가 없는 채로 뜹니다. 노드 1이 꺼져서 옮겨 간 거라면 데이터가 사라진 것처럼 보이죠. 그래서 방법은 크게 두 가지입니다.
- 데이터가 있는 노드에 고정합니다. 앞의 stack 파일처럼
placement로 DB를 노드 2에 묶어 두는 거예요. 대신 그 노드가 꺼지면 DB도 멈춥니다. - 어느 노드에서나 같은 데이터를 보게 합니다. 네트워크로 공유하는 디스크(NFS)를 볼륨으로 쓰는 방법이에요.
volumes:
  pgdata:
    driver: local
    driver_opts:
      type: nfs
      o: addr=10.0.10.50,nfsvers=4.1,rw
      device: ":/exports/postgres"
type: nfs와 서버 주소, 폴더 경로만 적으면 됩니다. 모든 노드에 NFS를 미리 마운트해 두고 그 폴더를 연결하는 방법도 있는데, 마운트 옵션이나 보안 설정을 운영체제에서 직접 다룰 수 있어서 저는 이쪽이 편했어요. 다만 DB를 NFS에 두면 파일 잠금이나 성능 문제가 생길 수 있어서, 큰 서비스라면 DB는 노드 로컬 디스크에 두고 그 노드에 고정하거나 매니지드 DB를 쓰는 경우가 많습니다. 참고로 Docker 23.0(2023)부터 Swarm에도 CSI 드라이버로 클러스터 볼륨을 만드는 기능이 실험 기능으로 들어와 있어요.
Kubernetes는 단계를 나눠 둡니다.
- Pod는 "디스크가 필요해요"라고만 합니다.
- PVC(PersistentVolumeClaim)는 요청서예요. "10Gi짜리, 한 노드에서 읽고 쓸 수 있는 디스크".
- StorageClass는 디스크를 어떻게 만들지입니다. 실제로 만드는 건 클라우드마다 다른 CSI 드라이버가 해요.
- PV(PersistentVolume)는 그렇게 만들어진 실제 디스크입니다. PVC와 짝지어져 Pod에 붙어요.
단계가 많아서 처음엔 어렵습니다. 하지만 클러스터에 StorageClass를 한 번 세팅해 두면 앱 쪽에서는 PVC만 적으면 디스크가 알아서 생겨요. 네 가지를 앱마다 다 적어야 하는 건 아닙니다. 다만 CSI 드라이버와 설정이 클라우드마다 달라서, 쓰는 클라우드의 공식 문서를 꼭 읽어야 합니다. 저도 OCI용 예시를 찾기 어려워서 고생했어요.
L7 라우팅: 프록시를 서비스로 띄운다
Kubernetes에는 도메인별 라우팅 규칙을 적는 표준 리소스(Ingress, 요즘은 Gateway API)가 있지만 Swarm에는 없습니다. 그래서 Traefik이나 NGINX 같은 프록시를 다른 서비스와 똑같이 stack 파일로 띄우고, 서비스마다 label로 라우팅 규칙을 붙입니다. 구성도에서 노드 1·3에 있던 Traefik이 이거예요.
services:
  web:
    image: my-web:1.4
    deploy:
      labels:
        - traefik.enable=true
        - traefik.http.routers.web.rule=Host(`app.example.com`)
        - traefik.http.routers.web.entrypoints=websecure
        - traefik.http.routers.web.tls=true
        - traefik.http.services.web.loadbalancer.server.port=8000
rule이 "Host가 app.example.com이면 이 서비스로"이고, entrypoints와 tls는 HTTPS로 받겠다는 뜻, 마지막 줄은 컨테이너 안에서 앱이 듣는 포트예요. Traefik이 Swarm에 물어봐서 label을 읽고 규칙을 알아서 만듭니다. 처음에 가장 많이 헤매는 곳이 두 군데예요.
- label은
deploy아래(서비스)에 붙여야 합니다. 서비스 바로 아래labels(컨테이너 label)에 적으면 Swarm 모드의 Traefik은 읽지 않아요. - Swarm에서는 Traefik이 포트를 스스로 알아내지 못해서 마지막
port줄이 꼭 필요합니다.
label의 도메인 규칙을 새 버전 서비스 쪽으로 옮기면 블루·그린 배포처럼 트래픽을 한 번에 넘길 수 있습니다. 반면 10%만 새 버전으로 보내는 가중치 카나리 배포는 label만으로는 안 되고 Traefik의 파일 설정을 함께 써야 해요. 서비스끼리 통신을 관리하는 서비스 메시 같은 층도 기본으로는 없습니다.
Kubernetes는 Ingress와 Gateway API가 표준 리소스라 프록시 제품을 바꿔도 규칙을 적는 형식이 같습니다. 다만 오래 쓰이던 Ingress 컨트롤러 ingress-nginx는 2026년 3월에 유지보수가 끝났어요. 지금 새로 배운다면 Gateway API부터 보는 게 좋습니다.
인증서: acme.json은 한 노드에만 생긴다
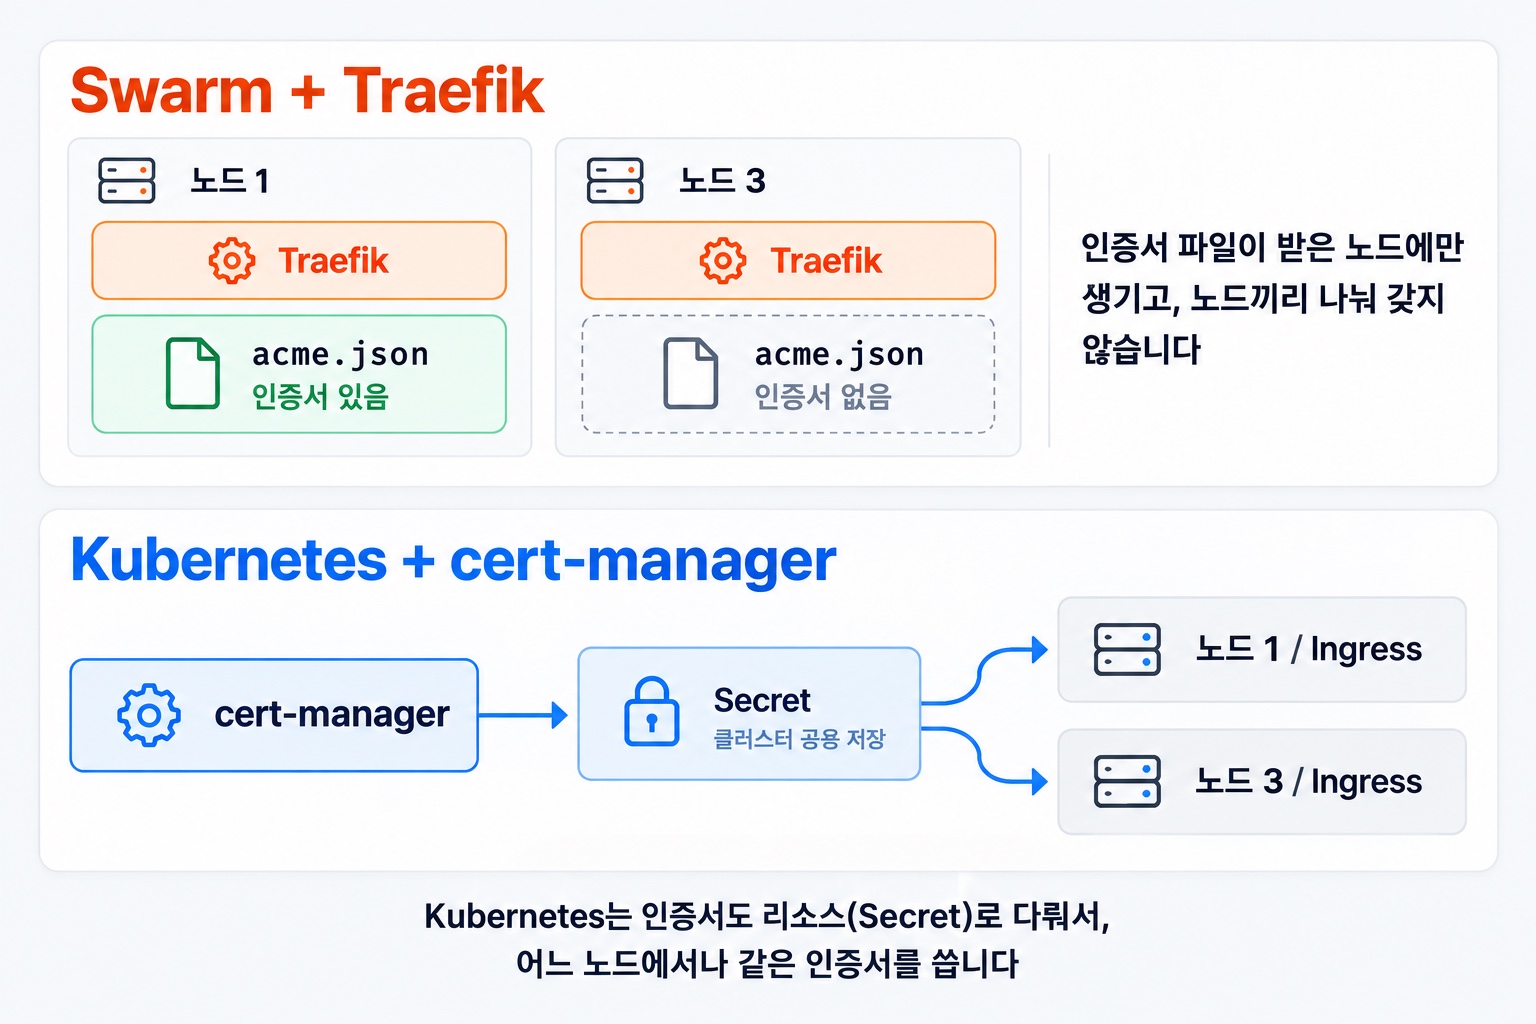
직접 운영하면서 꽤 고생한 부분입니다.
- Traefik은 Let's Encrypt에서 무료 인증서를 자동으로 받아 오고, 만료 전에 갱신도 해 줍니다. 여기까지는 편해요.
- 그런데 받은 인증서를 자기가 떠 있는 노드의 파일(
acme.json)에 저장합니다. - Traefik이 노드 1과 노드 3에 하나씩 떠 있으면, 노드 1이 받은 인증서를 노드 3의 Traefik은 모릅니다. 각자 따로 받으려 하거나, 한쪽은 인증서가 없는 상태가 돼요.
Swarm에는 이 파일을 모든 노드가 같이 보게 해 주는 장치가 기본으로 없습니다. 흔히 쓰는 해결책은 이렇습니다.
- Traefik을 한 노드에만 띄운다(
placement로 고정). 단, 그 노드가 꺼지면 HTTPS도 멈춥니다. - 앞단의 CDN(예: Cloudflare)에서 HTTPS를 처리하고, 서버 쪽에는 CDN이 발급해 주는 인증서를 Swarm secret으로 모든 노드에 나눠 준다.
- 인증서를 따로 발급해서 Swarm secret이나 공유 스토리지로 나눠 준다.
저는 공유 스토리지 쪽으로 풀었습니다. 다만 Traefik 두 개가 NFS에 둔 acme.json 하나를 함께 쓰게 하면, 둘이 동시에 인증서를 받거나 갱신하다가 파일이 꼬일 수 있어요. Traefik도 이 파일을 여러 인스턴스가 함께 쓰지 말라고 안내합니다. 그래서 인증서를 받는 쪽과 읽기만 하는 쪽을 나눴어요.
- 발급 담당 Traefik (노드 1): Let's Encrypt에서 인증서를 받고 갱신하는 건 이 하나만 합니다. Cloudflare API로 DNS 레코드를 만들어 도메인 소유를 증명하는 DNS-01 방식이라
*.example.com같은 와일드카드 인증서도 받을 수 있고, Cloudflare API 토큰은 Swarm secret으로 넣었어요. 받은 인증서는 NFS의acme.json에 저장됩니다. - traefik-certs-dumper (노드 1):
acme.json이 바뀔 때마다 그 안의 인증서를 도메인별.crt,.key파일로 꺼내 NFS의 다른 폴더에 풀어 둡니다. - 읽기 담당 Traefik (노드 3): 인증서를 직접 받지 않고, 풀어 둔 인증서 파일을 file provider로 읽기만 합니다. 파일이 바뀌면 알아서 다시 읽어요.
필요한 줄만 남기면 이런 모양입니다.
services:
  traefik-writer:
    command:
      - --certificatesresolvers.cf.acme.storage=/data/acme.json
      - --certificatesresolvers.cf.acme.dnschallenge.provider=cloudflare
    volumes:
      - /mnt/nfs/acme:/data          # acme.json은 NFS에
    deploy:
      placement:
        constraints:
          - node.labels.acme == writer

  certsdumper:
    image: ldez/traefik-certs-dumper:v2.10
    command: >
      file --watch --domain-subdir
      --source /mnt/nfs/acme/acme.json
      --dest /mnt/nfs/certs
    volumes:
      - /mnt/nfs:/mnt/nfs
    deploy:
      placement:
        constraints:
          - node.labels.acme == writer

  traefik-reader:
    command:
      - --providers.file.directory=/data
      - --providers.file.watch=true
    volumes:
      - /mnt/nfs/certs:/data         # 풀어 둔 인증서만 읽음
    deploy:
      placement:
        constraints:
          - node.labels.acme == reader
노드에 acme=writer, acme=reader 라벨을 붙여 각 서비스를 그 노드에 고정했어요. 이렇게 하면 어느 노드의 Traefik이든 같은 인증서를 쓰지만, 갱신은 노드 1에 달려 있다는 약점은 남습니다. NFS 서버도 하나뿐이라 마찬가지고요. Let's Encrypt 인증서는 90일짜리이고 Traefik이 만료 30일 전부터 갱신하니, 노드 1이 잠깐 꺼지는 정도로 바로 문제가 되진 않습니다.
Kubernetes에서는 cert-manager가 인증서를 받아서 클러스터 전체가 공유하는 Secret에 저장합니다. 그래서 어느 노드의 Ingress 컨트롤러든 같은 인증서를 써요. 인증서까지 API(리소스)로 다루니 이런 도구가 생길 수 있는 겁니다.
보안: 얇아서 편하고, 얇아서 직접 챙긴다
Swarm 노드끼리 통신하려면 포트 세 개만 열면 됩니다.
| 포트 | 용도 |
|---|---|
| 2377/tcp | 클러스터 관리 (manager) |
| 7946/tcp·udp | 노드끼리 상태와 네트워크 정보 주고받기 |
| 4789/udp | 오버레이 네트워크 (VXLAN) |
그래서 firewalld나 SELinux 같은 보안 장치를 켠 채로 이 포트만 열어 주면 돼요. 얇다고 아무것도 없는 건 아닙니다. 노드끼리의 관리 통신은 기본으로 상호 TLS로 암호화되고 인증서 교체도 자동이며, manager가 저장하는 클러스터 상태(Raft 로그)와 secret도 암호화돼 있어요. 컨테이너끼리 오가는 오버레이 네트워크 데이터는 기본으로 암호화되지 않으니, 필요하면 네트워크를 만들 때 --opt encrypted를 줍니다(조금 느려집니다).
운영할 때: ufw로 막았는데 포트가 열려 있다
Docker는 포트를 열 때 iptables 규칙을 직접 추가합니다. 그래서 ufw 같은 방화벽 도구로 막아 둔 포트라도, 서비스에서 publish한 포트는 밖에서 접속될 수 있어요. 앞의 구성에서는 서버가 사설 서브넷에 있고 밖에서 들어오는 길이 NLB뿐이라 이 문제를 피할 수 있었어요. 서버에 공인 IP가 붙어 있다면 클라우드 쪽 방화벽(보안 그룹, 보안 목록)에서 막는 게 확실합니다.
Kubernetes는 보안 정책을 리소스로 선언해서 관리합니다.
- RBAC: "이 사람(또는 프로그램)은 이 Namespace의 Pod만 볼 수 있다" 같은 권한
- NetworkPolicy: "결제 Pod에는 주문 Pod만 접속할 수 있다" 같은 Pod 단위 방화벽
- Namespace: 팀이나 환경별로 리소스를 나누는 구역
- CNI: 네트워크를 맡는 플러그인을 골라 끼우는 구조. NetworkPolicy를 실제로 지키는 것도 CNI예요
여러 팀이 한 클러스터를 같이 쓰는 큰 조직에는 꼭 필요하지만, 혼자나 작은 팀이 운영하기엔 무겁습니다. 이 개념들을 다 알아야 시작할 수 있다는 게 Kubernetes의 진입 장벽이기도 하고요.
관측: 대시보드를 가져왔더니 절반이 N/A
운영하면서 가장 시간을 많이 쓴 부분입니다. 개발자라면 그럴듯한 메트릭 대시보드 한 번쯤 띄워 보고 싶잖아요. Kubernetes에서는 Prometheus와 Grafana를 붙이면 화려한 대시보드가 꽤 쉽게 뜨는데, Swarm은 그렇지 않았습니다.
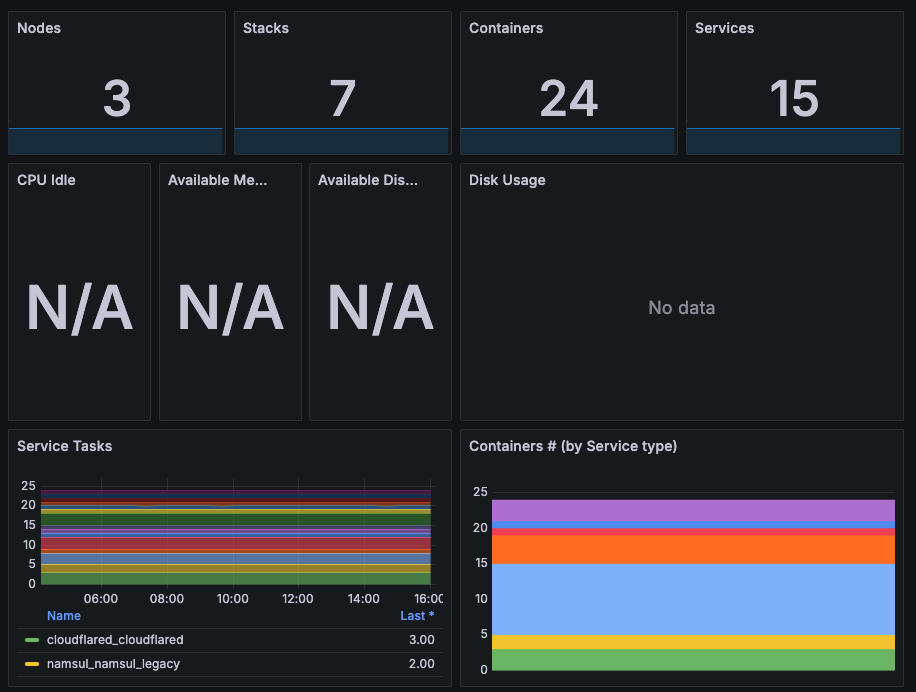
공개된 Swarm용 Grafana 대시보드를 가져와 붙인 첫 화면입니다. 노드, 스택, 컨테이너 수는 나오는데 CPU, 메모리, 디스크 같은 중요한 패널이 비어 있어요. 대시보드가 기대하는 지표를 내보내는 프로그램(exporter)이 없거나, 지표 이름과 라벨이 제 환경과 달라서입니다.
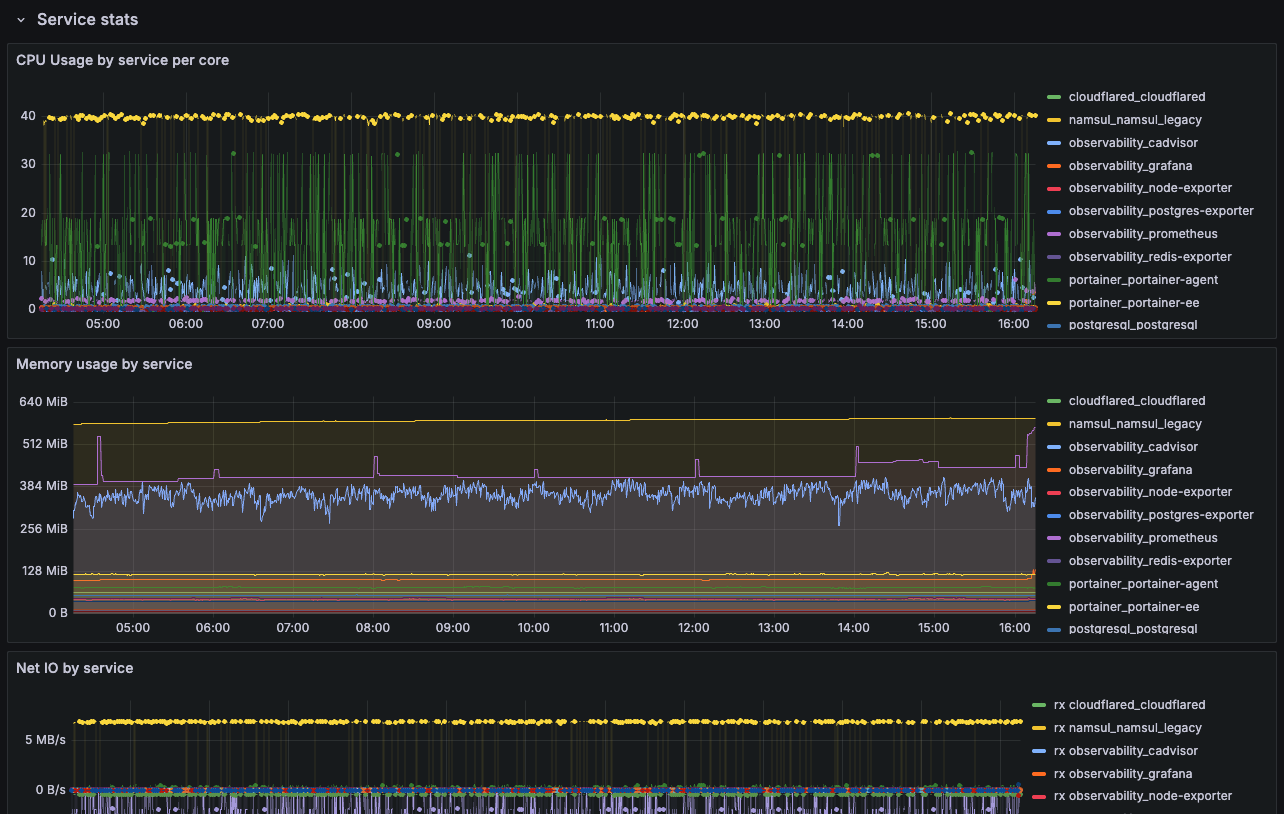
노드마다 exporter(node-exporter, cAdvisor 등)를 직접 띄우고, 대시보드의 쿼리를 하나하나 고친 뒤의 화면입니다. 이제야 서비스별 CPU, 메모리, 네트워크가 채워졌어요. 차이를 정리하면 이렇습니다.
| Swarm | Kubernetes | |
|---|---|---|
| 지표 | exporter를 노드마다 직접 배치 | 클러스터 구성 요소가 표준 메트릭을 냄 |
| 수집 대상 찾기 | 주소를 직접 적거나 dockerswarm_sd_configs (예제가 적음) |
kubernetes_sd_configs가 Pod, Service, Node를 자동으로 찾고 라벨도 붙임 |
| 설치 | Prometheus, Grafana, exporter 파일을 하나씩 | Helm 차트(kube-prometheus-stack)로 한 번에 |
| 대시보드·알림 | 직접 만들고 고침 | 기본 대시보드와 알림 규칙이 딸려 옴 |
| 로그 | Loki 같은 수집기를 따로 배치 | DaemonSet으로 노드마다 수집, 예제가 많음 |
기능 차이라기보다 생태계 차이입니다. 같은 Prometheus와 Grafana를 쓰는데도, 쓰는 사람이 많은 쪽에 이미 만들어진 게 훨씬 많아요. 그래서 오히려 초보자에게는 이 부분이 Kubernetes보다 Swarm이 더 어렵습니다. 회사에서 잘 만들어진 대시보드를 그냥 볼 때는 몰랐는데, 직접 해 보니 쿼리 하나하나가 다 손이 가는 일이었어요.
배포 자동화: Argo CD 대신 Portainer와 CI
Kubernetes에서는 GitOps가 흔합니다. Git 저장소의 설정 파일을 정답으로 두고, Argo CD나 Flux 같은 도구가 클러스터의 실제 상태가 Git과 같은지 계속 비교해서 맞춰요. 앞 글에서 본 조정 루프를 배포에까지 적용한 셈입니다.
Swarm에는 Argo CD 같은 도구가 없어서 Portainer를 썼습니다.
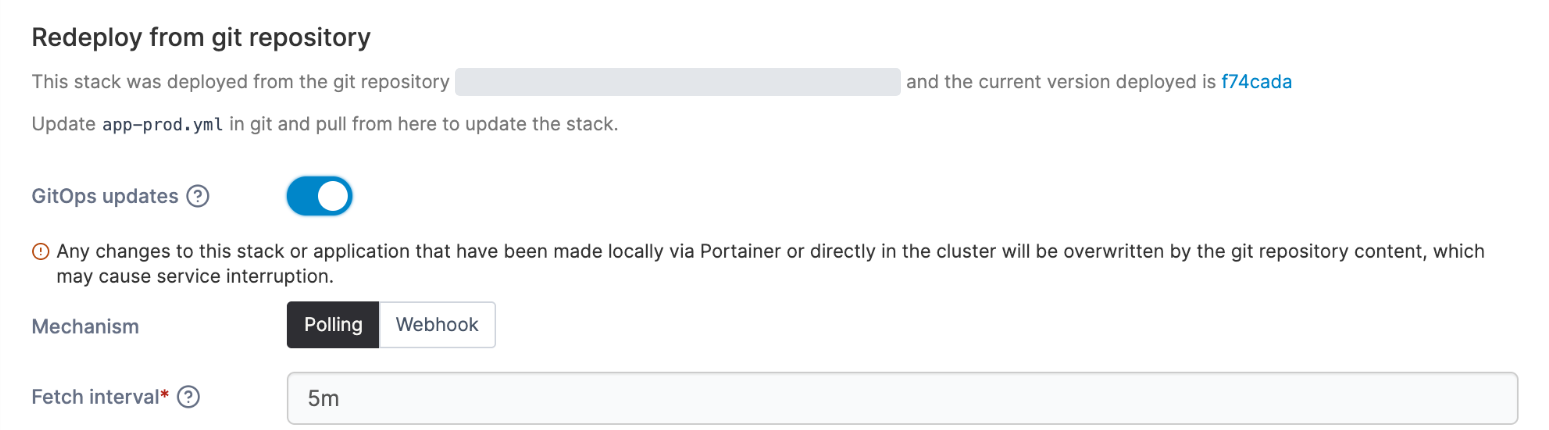
- Portainer는 웹 화면에서 컨테이너, 서비스, 스택을 관리하는 도구입니다. 화면처럼 Git 저장소를 연결해 두면 5분마다 확인해서, 바뀌었으면 스택을 다시 배포해 줘요.
- 하지만 GitOps 도구는 아닙니다. Argo CD처럼 Git과 지금 클러스터가 어디가 다른지 보여 주고 되돌리는 기능, 배포 이력을 관리하는 기능이 약해요.
- 그래서 GitHub Actions 같은 CI에서 이미지를 빌드하고, 배포 스크립트를 직접 만들어 보완했습니다.
Swarm 쪽 장점도 하나 있어요. stack 파일 하나에 서비스, secret, config가 다 들어 있어서 관리할 파일 자체는 단순합니다. Kubernetes는 앱 하나에도 Deployment, Service, Ingress, ConfigMap, Secret … 리소스가 여럿이고, 개발·운영 환경까지 나누면 파일이 금방 열 개를 넘어가거든요. 참고로 Portainer Business Edition은 노드 3개까지 무료로 쓸 수 있었습니다(조건은 바뀔 수 있어요). 오픈소스 Community Edition도 있습니다.
그리고 지금은 Kubernetes로
Swarm으로 오케스트레이션이 어떻게 돌아가는지 감을 잡은 뒤, 지금은 Kubernetes로 옮겼습니다. 이유는 두 가지예요.
- Swarm의 아쉬운 점: 위에서 본 것처럼 자동 확장이 없고, 인증서, 관측, 배포 자동화를 하나하나 직접 조립해야 했어요.
- 배우기 위해서: 실무에서 쓰는 건 대부분 Kubernetes라, Swarm에서 익힌 개념을 Kubernetes에서 이어서 익히고 싶었습니다.
바로 옮기지는 않고, 먼저 가벼운 Kubernetes인 k3s로 테스트 클러스터를 띄워 이것저것 시험해 본 뒤 넘어갔어요. 지금은 OCI의 매니지드 Kubernetes인 OKE(Oracle Kubernetes Engine)를 씁니다. 컨트롤 플레인을 OCI가 관리해 주니 Swarm에서처럼 manager를 몇 대 둘지 직접 챙길 필요가 없어요. OKE의 기본(Basic) 클러스터는 컨트롤 플레인 요금을 받지 않고 워커 노드는 일반 VM처럼 계산돼서, Always Free 자원으로 만든 노드를 워커로 쓸 수 있습니다. 대신 기본 클러스터에는 컨트롤 플레인 SLA가 없어요.
돌아보면 Swarm은 Kubernetes로 가기 전에 거쳐 가기 좋은 단계였습니다. 원하는 상태, 스케줄링, 서비스, 레플리카 같은 개념은 그대로 가져갔고, cgroup이나 오버레이 네트워크처럼 노드에서 실제로 일어나는 일도 같았어요. Swarm에서 직접 조립하느라 고생한 관측, 인증서, 배포 자동화는 Kubernetes에서는 kube-prometheus-stack, cert-manager, Argo CD처럼 이미 만들어진 도구로 채울 수 있습니다.
제가 Kubernetes를 처음 공부할 때는 물어볼 LLM이 없어서 더 어렵게 느껴졌는데, 요즘은 클러스터를 띄우는 것 자체는 훨씬 쉬워졌습니다. 그래도 뭔가 이상할 때 원인을 찾으려면 결국 노드에서 무슨 일이 일어나는지, 커널이 무엇을 하는지를 알아야 해요. Kubernetes가 처음부터 너무 어렵게 느껴진다면 Swarm으로 가볍게 시작해서 감을 잡고 넘어가도 좋습니다.
정리
- OCI Always Free의 ARM 4코어·24GB는 VM 여러 대로 나눌 수 있어서, 노드 3개짜리 클러스터를 0원으로 운영할 수 있었습니다. ARM 이미지와 조건 변경은 미리 챙기세요.
- Swarm은 compose 파일에
deploy만 더하면 클러스터에 올라가서, 혼자 운영하기에 부담이 적었습니다. - 대신 자동 확장, 노드를 넘나드는 볼륨, 인증서 공유, 관측, GitOps는 Kubernetes만큼 갖춰져 있지 않아 직접 조립해야 했습니다.
- 그 차이는 기능보다 생태계에서 크게 났고, 개념과 커널 기능은 Kubernetes로 그대로 이어졌습니다.