컨테이너 오케스트레이션: Compose, Swarm, Kubernetes는 무엇이 다를까
서버 한 대라면 docker compose로 충분합니다. 서버가 여러 대가 되면 무엇이 문제가 되고, 오케스트레이터는 그걸 어떻게 대신 해 줄까요? 같은 앱을 Compose, Docker Swarm, Kubernetes로 띄워 보며 차이를 비교했습니다.
목차
앞의 두 글에서 컨테이너는 리눅스 커널이 격리해서 돌리는 프로세스 묶음이라는 걸 봤습니다. 그런데 커널은 자기 서버 하나만 압니다. 같은 서버 안의 컨테이너는 나누고 제한해 주지만, 옆 서버에 뭐가 떠 있는지는 모르죠.
서버가 한 대일 때는 문제가 없습니다. 여러 대가 되는 순간 "이 컨테이너를 어느 서버에 띄우지?", "서버 하나가 꺼지면 누가 다시 띄우지?" 같은 질문이 생겨요. 이 질문에 대신 답해 주는 도구가 오케스트레이터입니다.
답부터 말하면 세 줄이에요.
- Compose는 서버 한 대 안에서 컨테이너 여러 개를 파일 하나로 띄우는 도구입니다.
- 서버가 여러 대가 되면 어디에 띄우고, 죽으면 다시 띄우고, 끊김 없이 바꿔 주는 지휘자가 필요합니다. 그게 Docker Swarm, Kubernetes 같은 오케스트레이터예요.
- 오케스트레이터도 격리와 제한은 각 서버의 커널에 맡깁니다. 정하는 건 '어디에, 몇 개'뿐이에요.
서버 한 대라면 Compose로 충분하다
docker run은 컨테이너 하나를 띄웁니다. 웹 서버, API 서버, DB를 함께 띄우려면 docker run을 세 번 쳐야 하고, 네트워크와 볼륨도 따로 만들어야 하죠. docker compose는 이걸 파일 하나에 적어 두고 한 번에 띄우는 도구입니다.
# compose.yml
services:
  proxy:
    image: nginx:alpine
    ports:
      - "80:80"
  api:
    image: my-api:1.0
  db:
    image: postgres:17
    volumes:
      - pgdata:/var/lib/postgresql/data

volumes:
  pgdata:
docker compose up -d
세 컨테이너가 같은 네트워크에 뜨고, api는 db라는 서비스 이름으로 DB에 접속할 수 있어요. 서버 한 대로 충분한 서비스라면 여기서 멈춰도 됩니다. 실제로 사이드 프로젝트나 개발 환경은 대부분 이걸로 충분해요.
다만 compose가 말을 거는 대상은 그 서버의 Docker 하나입니다. 서버를 여러 대로 늘려도 compose는 다른 서버를 모릅니다.
서버가 여러 대가 되면 생기는 질문
서버가 세 대이고, 웹 애플리케이션 컨테이너를 여러 개 띄워야 한다고 해 볼게요.
- 어느 서버에 띄우지? 서버마다 남은 CPU와 메모리가 다릅니다.
- 죽으면 누가 다시 띄우지? 컨테이너가 죽는 건 재시작 정책으로 되지만, 서버째 꺼지면 그 서버의 컨테이너는 다른 서버로 옮겨 띄워야 합니다.
- 배포하는 동안 안 끊기게 하려면? 새 버전으로 바꾸는 동안에도 사용자는 계속 접속하고 있어요.
- 컨테이너끼리 어떻게 찾지? API 컨테이너는 DB 컨테이너를 찾아야 하는데, 둘이 다른 서버에 있을 수도 있습니다.
- 사람이 몰리면? 컨테이너를 늘려야 하고, 한가해지면 줄여야 합니다.
서버 두세 대에 컨테이너 몇 개라면 사람이 해도 됩니다. 하지만 컨테이너가 수십, 수백 개가 되면 사람 손으로는 감당이 안 되죠.
오케스트레이션이란
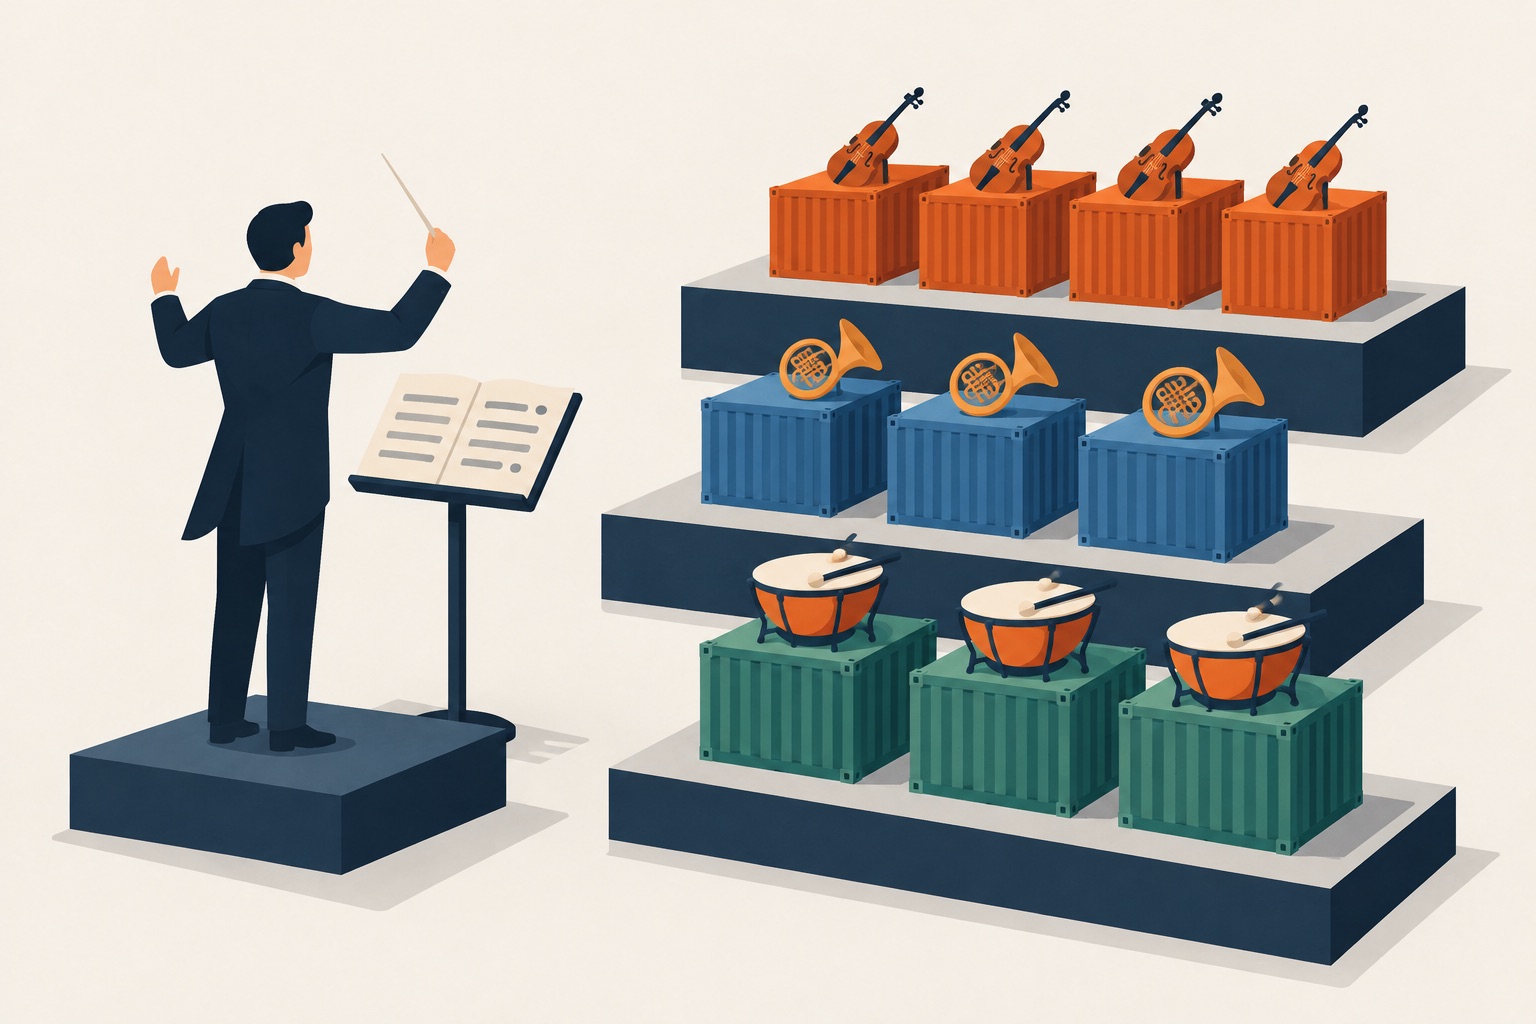
오케스트레이션(orchestration)은 원래 오케스트라의 편곡과 지휘를 뜻하는 말입니다. 비유가 꽤 그대로 들어맞아요.
| 오케스트라 | 컨테이너 세상 |
|---|---|
| 연주자 | 컨테이너 |
| 악보 (누가, 몇 명이, 얼마나) | 설정 파일 (어떤 이미지를 몇 개, CPU·메모리는 얼마나) |
| 지휘자 | 오케스트레이터 |
| 무대 | 서버 여러 대 |
연주자들이 악보를 보고 연주하듯, 우리는 설정 파일에 원하는 모습을 적고 오케스트레이터가 서버 여러 대에 흩어진 컨테이너를 그대로 맞춰 줍니다. 대표적인 오케스트레이터는 이렇습니다.
- Kubernetes: 사실상 업계 표준입니다.
- Docker Swarm: Docker에 처음부터 들어 있는 오케스트레이터예요.
- 그 밖에 AWS의 ECS, HashiCorp의 Nomad 같은 것도 있습니다.
왜 나왔고, 어떻게 Kubernetes가 표준이 됐나
2013년 Docker가 공개되면서 누구나 컨테이너를 쉽게 만들게 됐습니다. 컨테이너가 쉬워지자 서비스를 잘게 쪼개는 방식이 유행했고, 회사마다 컨테이너가 수십, 수백 개로 늘었죠. 자연스럽게 이걸 지휘할 도구가 필요해졌습니다.
| 시기 | Kubernetes | Docker Swarm |
|---|---|---|
| 2014년 | 6월 Google이 공개. 사내 시스템 Borg를 운영한 경험으로 새로 만든 것 | 12월 Docker가 발표 |
| 2015년 | 7월 1.0 출시, 새로 만든 재단 CNCF에 기증 | 11월 1.0 출시 |
| 2016년 | Docker 1.12에 내장 (swarm mode) | |
| 지금 | 1년에 세 번 새 버전, 사실상 표준 | 큰 신기능보다 유지보수 위주 |
흔히 "구글이 Borg를 공개한 게 Kubernetes"라고들 하는데, Borg는 지금도 구글 사내 시스템입니다. Kubernetes는 Borg를 운영하며 얻은 교훈으로 새로 만든 프로젝트예요.
둘은 거의 같은 시기에 경쟁하듯 나왔습니다. 갈린 지점으로 흔히 꼽는 게 CNCF예요. Kubernetes는 1.0과 함께 Linux Foundation 아래 새로 생긴 CNCF(Cloud Native Computing Foundation)에 기증되면서, 한 회사가 아니라 업계가 함께 만드는 프로젝트가 됐습니다. Swarm은 Docker라는 한 회사의 제품으로 남았고요.
지금 두 도구의 처지는 꽤 다릅니다.
- Kubernetes는 1년에 세 번 새 마이너 버전이 나옵니다. 공식 프로젝트가 패치를 내는 건 최신 세 버전, 한 버전당 1년 2개월 정도라서 계속 따라 올려야 해요. 오래된 버전도 돌아가긴 하지만 보안 패치가 끊기고, EKS 같은 매니지드 서비스는 지원이 끝난 버전을 강제로 올리거나 추가 요금을 받습니다.
- Swarm은 Docker 엔진에 그대로 들어 있고 지금도 유지보수됩니다. 다만 큰 기능은 드물게 들어와요(2023년 Docker 23.0에 CSI 스토리지 연동이 실험 기능으로 들어간 정도). Docker의 기업용 사업을 2019년에 인수한 Mirantis는 상용 제품에서 Swarm을 최소 2030년까지 지원하겠다고 밝혔습니다.
오케스트레이터가 대신 해 주는 다섯 가지
앞의 질문 다섯 개에 오케스트레이터가 하는 일을 붙이면, 흔히 듣는 용어가 됩니다. 이름은 외우지 않아도 괜찮아요. "이런 걸 대신 해 주는구나"가 먼저입니다.
| 질문 | 오케스트레이터가 하는 일 | 부르는 이름 |
|---|---|---|
| 어느 서버에 띄우지? | 자리가 남는 서버를 골라 배치 | 스케줄링 (scheduling) |
| 죽으면 누가 다시 띄우지? | 다른 서버에 새로 띄움 | 자가 치유 (self-healing) |
| 배포 중에 안 끊기게 하려면? | 한꺼번에 말고 하나씩 차례로 바꿈 | 롤링 업데이트 (rolling update) |
| 컨테이너끼리 어떻게 찾지? | 이름만 알면 찾아가게 해 줌 | 서비스 디스커버리 (service discovery) |
| 사람이 몰리면? | 개수를 늘리고 줄임 | 스케일링 (scaling) |
몇 가지만 덧붙이면 이렇습니다.
- 스케일링은 방향에 따라 이름이 달라요. 컨테이너나 서버 개수를 늘리는 건 스케일 아웃, 줄이는 건 스케일 인입니다. 개수 대신 하나의 크기(CPU, 메모리)를 키우는 건 스케일 업이라고 해요.
- 롤링 업데이트 말고도 배포 방식은 여럿입니다. 새 버전에 트래픽을 10%만 먼저 보내 보고 괜찮으면 늘리는 카나리 배포가 대표적이에요. 옛날 탄광에서 유독가스를 먼저 알아채라고 카나리아를 데려갔던 데서 온 이름입니다.
- 서비스 디스커버리는 파고들면 DNS, 가상 IP, 커널의 로드밸런서까지 이어지는 깊은 주제예요. 지금은 "서버가 여러 대여도 이름으로 찾게 해 준다"까지만 잡아도 충분합니다.
그림 한 장으로 보는 클러스터
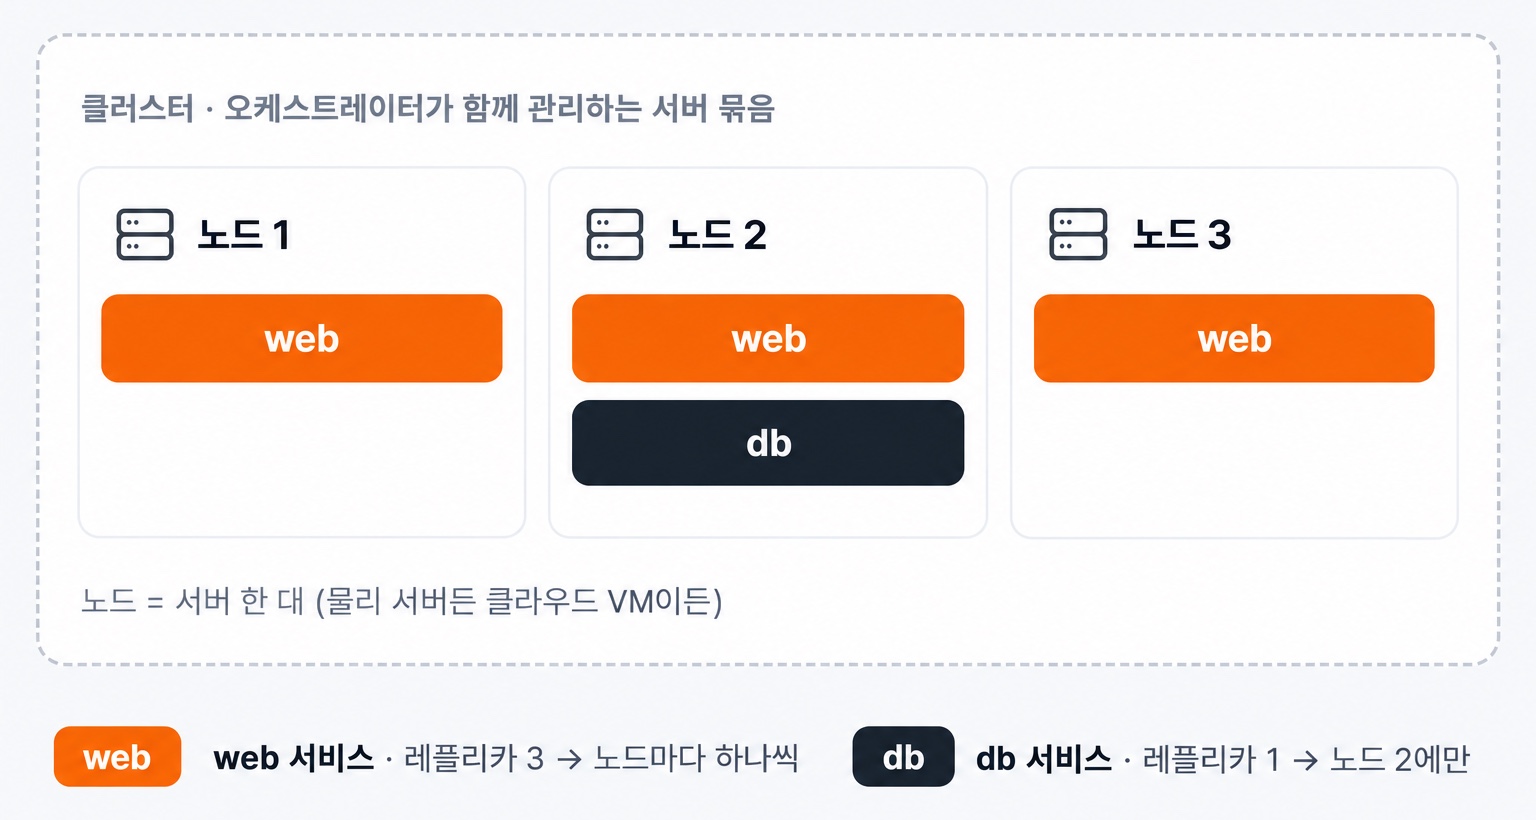
오케스트레이터 이야기에서 계속 나오는 단어 네 개를 이 그림으로 잡고 갈게요.
- 클러스터: 오케스트레이터가 함께 관리하는 서버 묶음입니다.
- 노드: 클러스터에 속한 서버 한 대예요. 물리 서버일 수도, 클라우드의 VM일 수도 있지만 "서버 한 대"로 생각하면 됩니다.
- 서비스: "이 이미지로 컨테이너를 띄워라"라는 단위입니다. 그림의 web과 db가 각각 서비스예요.
- 레플리카: 한 서비스를 몇 개 띄울지입니다. web은 레플리카 3이라 노드마다 하나씩, db는 레플리카 1이라 노드 2에만 떠 있어요.
DB도 오케스트레이터에 올려도 될까?
그림에서는 DB도 클러스터 안에 있지만, 실무에서는 DB를 따로 두는 경우가 많습니다. DB가 죽으면 그 DB를 쓰는 서비스가 전부 멈추고, 데이터가 어느 노드의 디스크에 있느냐가 중요해서 '아무 노드에나 옮겨 띄우기'가 잘 맞지 않거든요. 작은 서버 환경이나 실험용으로는 함께 띄우기도 합니다. 의견이 꽤 갈리는 주제라 검색해 보면 긴 토론이 많이 나와요.
원하는 상태를 적어 두면, 계속 맞춰 준다
오케스트레이터를 관통하는 생각이 하나 있습니다. 명령하지 않고, 원하는 상태를 적는다는 거예요.
- 명령형:
docker run을 세 번 치면 컨테이너가 세 개 뜹니다. 그중 하나가 죽으면? Docker는 "세 개여야 한다"는 걸 모릅니다. 명령을 세 번 받았을 뿐이니까요. 사람이 다시 쳐야 합니다. - 선언형: 설정 파일에
replicas: 3, 즉 "이 서비스는 항상 3개여야 한다"고 적어 둡니다. 하나가 죽으면 오케스트레이터가 알아서 다시 3개로 맞춰요.
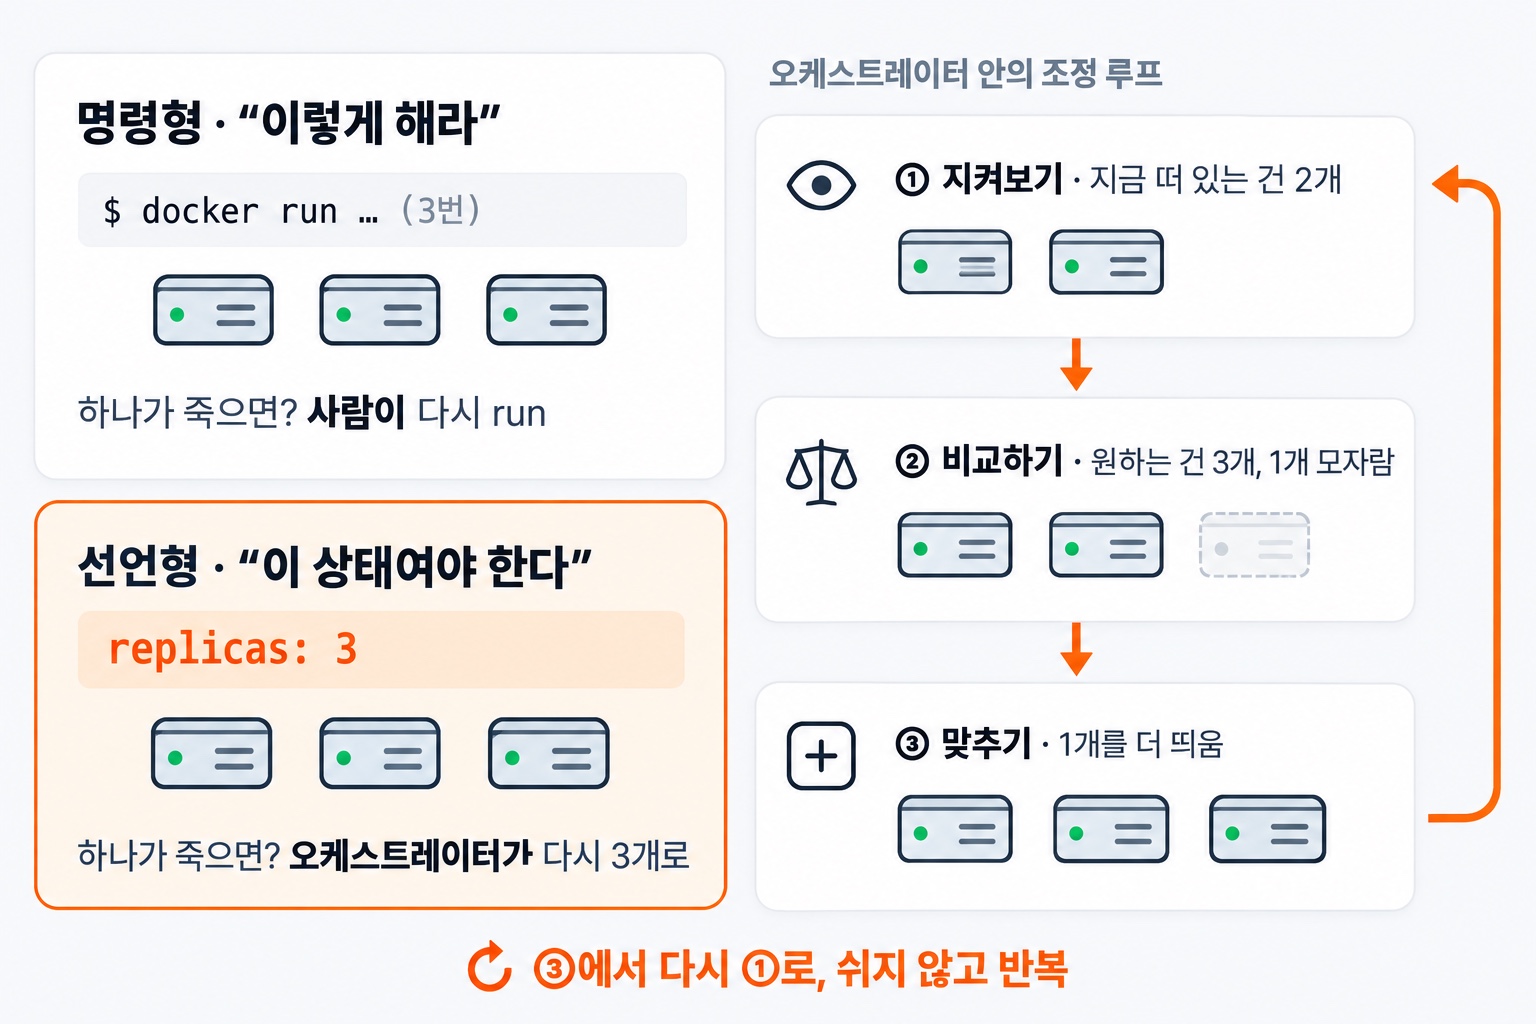
오케스트레이터 안에서는 이 루프가 쉬지 않고 돕니다. 이걸 조정 루프(reconciliation loop)라고 불러요.
- 지켜보기: 지금 실제로 떠 있는 건 2개.
- 비교하기: 원하는 건 3개니까 1개 모자람.
- 맞추기: 1개를 더 띄움. 그리고 다시 1번으로.
에어컨 온도를 24도로 맞춰 두는 것과 같습니다. 우리는 "지금 냉방 켜"가 아니라 "24도"만 정하고, 에어컨이 계속 온도를 재면서 켜졌다 꺼졌다 하죠. 앞에서 본 자가 치유와 스케일링도 결국 이 루프의 결과입니다.
"compose 파일도 YAML로 원하는 모습을 적잖아요?" 맞아요. 다만 compose는 up 할 때 한 번 맞춰 줄 뿐이고, 그 뒤로 서버가 꺼지는 것까지 지켜보며 다른 서버로 옮겨 주지는 않습니다.
Docker Swarm: Docker에 들어 있는 오케스트레이터
Docker Swarm은 한 문장으로 Compose의 사용감 그대로, 서버 여러 대로 넓힌 것입니다.
- 따로 설치할 게 없습니다. Docker 엔진에 이미 들어 있어서
docker swarm init한 줄이면 그 서버가 클러스터가 됩니다. - compose 파일을 거의 그대로 씁니다.
deploy블록만 더해서docker stack deploy로 올리면 돼요. - 작고 단순합니다. 서버 몇 대에 운영할 사람이 한두 명인 팀에 잘 맞고, 서버 한 대에서 오케스트레이터 기능만 쓰려고 켜기도 합니다.
Swarm에서 쓰는 단어는 셋입니다.
| 단어 | 뜻 |
|---|---|
| 서비스 | "이 이미지로 몇 개"라는 원하는 상태. compose 파일의 services와 같은 말입니다 |
| 태스크 | 서비스가 띄운 컨테이너 한 개의 자리. 레플리카가 3이면 태스크가 3개입니다 |
| 스택 | 서비스 여러 개를 묶은 파일 하나. compose 파일 하나가 스택 하나예요 |
manager가 정하고, worker가 띄운다
Swarm 클러스터의 노드는 두 종류입니다.
- manager는 두뇌입니다. 원하는 상태를 저장하고, 조정 루프를 돌면서 어느 노드에 어떤 태스크를 놓을지 정해요.
- worker는 손발입니다. 배정받은 태스크를 실행하고 상태를 manager에 보고합니다.
docker swarm init                 # 이 서버를 첫 manager로 만들며 클러스터 시작
docker swarm join --token …       # 다른 서버에서 실행하면 클러스터에 붙음
docker node ls                    # 노드 목록 (manager에서)
manager가 한 대면 그 서버가 꺼질 때 관리할 주체가 없어지니, 보통 여러 대를 둡니다. 이때 manager들은 Raft라는 합의 방식으로 상태를 나눠 저장하고, 과반수가 동의해야 결정해요. 그래서 manager는 홀수로 둡니다.
| manager 수 | 과반수 | 꺼져도 버티는 수 |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
4대로 늘려도 버티는 수는 3대와 같은 1대라서 짝수는 손해입니다.
과반수를 잃으면 클러스터가 다 멈출까요? 아닙니다. 이미 떠 있는 컨테이너는 계속 돕니다. 멈추는 건 새로 배포하기, 개수 바꾸기, 노드 붙이기 같은 관리 작업이에요. 꺼진 manager를 되살리는 게 가장 좋고, 안 되면 살아남은 manager에서 docker swarm init --force-new-cluster로 클러스터를 다시 세웁니다.
그리고 Swarm의 manager는 기본으로 일도 합니다. 작은 클러스터에서는 노드 세 대를 모두 manager로 두고 컨테이너도 띄우는 경우가 많아요. 관리만 시키고 싶으면 docker node update --availability drain으로 비웁니다.
검색하다 헷갈리기 쉬운 점: Swarm은 두 번 태어났다
2014년에 나온 처음 Swarm(classic Swarm)은 Docker와 따로 띄우는 별도 프로그램이었고, 클러스터 정보를 Consul이나 etcd 같은 외부 저장소에 따로 보관했습니다. 지금은 지원이 끝났어요. 2016년 Docker 1.12부터 엔진에 들어간 swarm mode가 지금 말하는 Swarm입니다. 자료를 찾다가
docker run swarm manage나consul://같은 설정이 나오면 옛날 Swarm 이야기예요.docker service,docker stack명령을 쓰는 자료를 보면 됩니다.
Kubernetes: 사실상 표준이 된 오케스트레이터
Kubernetes의 구조도 Swarm과 꽤 닮았습니다.
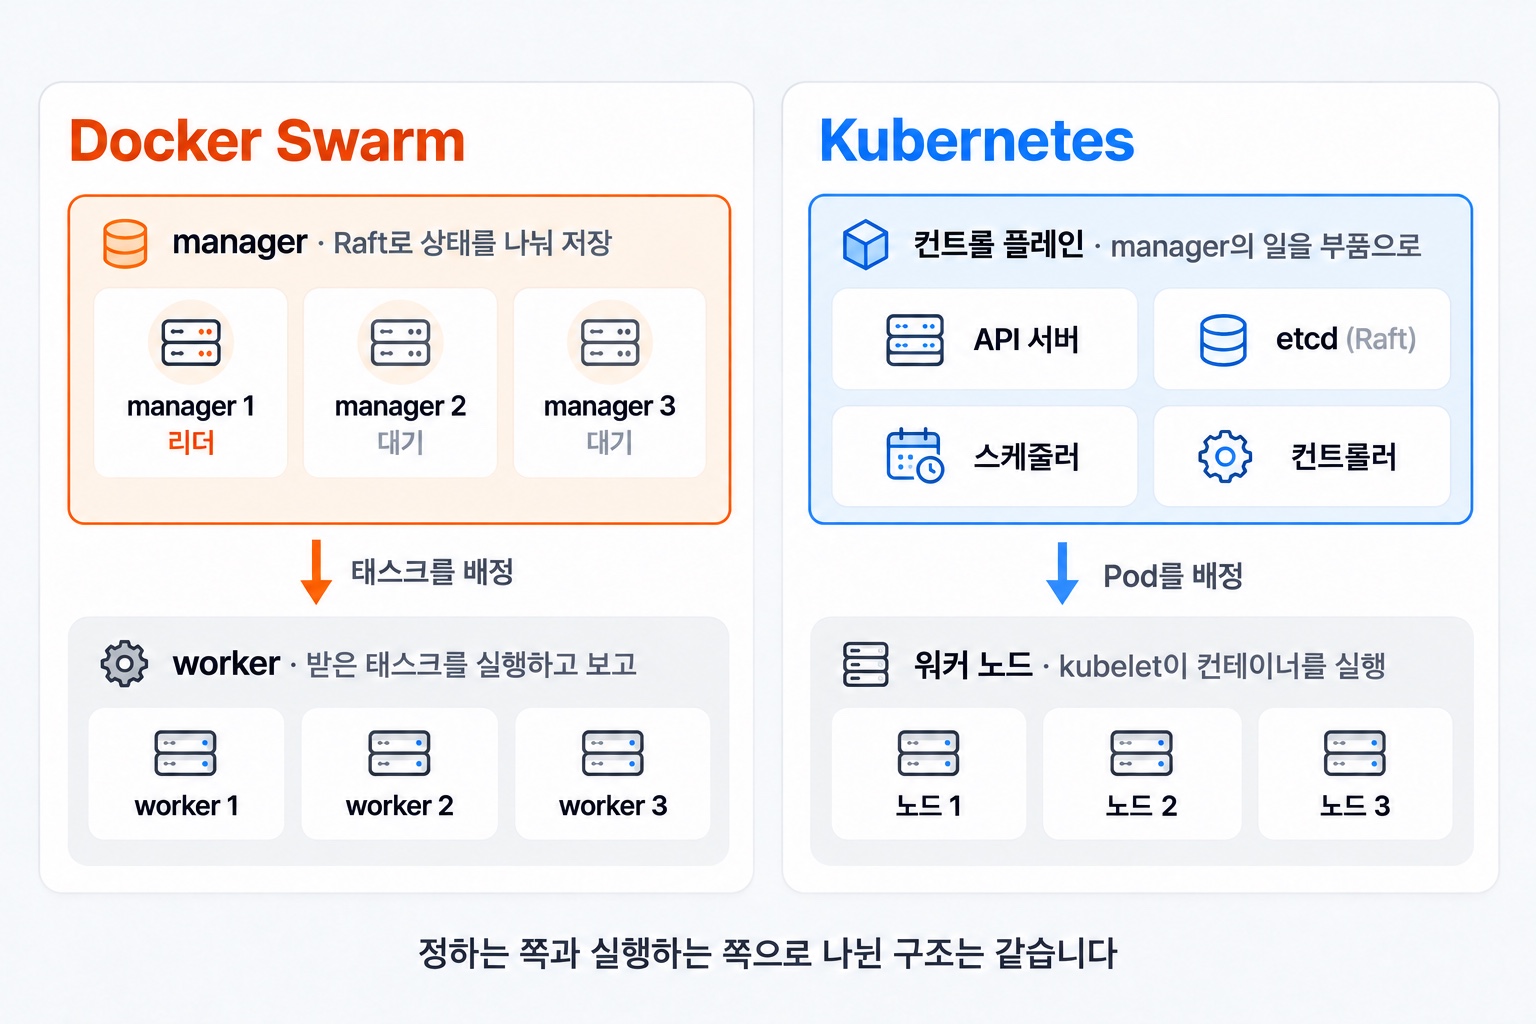
- 컨트롤 플레인이 Swarm의 manager 자리입니다. 역할이 부품으로 나뉘어 있어요.
- API 서버: 모든 요청을 받는 창구입니다.
kubectl명령도 여기로 갑니다. - etcd: 클러스터 상태를 저장하는 곳이에요. Swarm manager처럼 Raft를 써서 홀수로 둡니다.
- 스케줄러: 새 Pod를 어느 노드에 놓을지 정합니다.
- 컨트롤러: 앞에서 본 조정 루프를 실제로 도는 주인공들입니다. "3개여야 하는데 2개네? 하나 더."
- API 서버: 모든 요청을 받는 창구입니다.
- 워커 노드에서는 kubelet이라는 프로그램이 배정받은 Pod를 실제 컨테이너로 띄웁니다.
앱을 띄울 때 다루는 리소스는 우선 세 가지만 알면 됩니다.
| Kubernetes 리소스 | 하는 일 | Swarm에서 비슷한 것 |
|---|---|---|
| Pod | 컨테이너 묶음. 가장 작은 실행 단위 | 태스크 |
| Deployment | Pod를 N개 유지 | 서비스 (레플리카) |
| Service | Pod 여러 개에 이름과 고정 주소 하나 | 서비스 이름과 가상 IP |
이름이 헷갈리는 부분이 있어요. Swarm의 서비스 하나가 Kubernetes에서는 Deployment + Service 두 개로 나뉘어 있다고 보면 됩니다.
Kubernetes는 모든 걸 API로 다루고, 그 API가 표준이라 위에 수많은 도구가 자랐습니다. 패키지 관리 Helm, 배포 자동화 Argo CD, 인증서 자동 발급 cert-manager 같은 것들이요. 이 생태계가 Kubernetes가 표준이 된 큰 이유입니다. 직접 설치하기보다 AWS의 EKS, Google의 GKE, Azure의 AKS 같은 매니지드 서비스로 많이 씁니다.
몇 대부터 써야 할까요? 공식 권장 대수가 있는 건 아닙니다. 다만 컨트롤 플레인이 꺼져도 버티게(고가용성) 하려면 etcd 과반수 때문에 컨트롤 플레인만 3대가 필요하고, 일할 워커 노드까지 더하면 보통 5대 이상이 됩니다. 게다가 kubeadm처럼 표준 방식으로 설치하면 컨트롤 플레인 노드에는 기본으로 일반 Pod를 올리지 않아요. 연습용이라면 노트북 한 대의 minikube, kind, k3s로도 충분합니다. Swarm도 manager가 꺼져도 버티게 하려면 3대가 필요한 건 같습니다. 차이는 대수보다 얼마나 무겁고 복잡하냐에 있어요.
이름 이야기: K8s와 K3s
Kubernetes를 K8s라고 쓰는 건 K와 s 사이에 글자가 8개(ubernete)라서입니다. 가벼운 Kubernetes 배포판 K3s는 여기서 나온 말장난이에요. 메모리를 절반만 쓰는 Kubernetes를 만들고 싶었는데, 10글자의 절반은 5글자이니 K와 s 사이에 3글자, 그래서 K3s라고 합니다. 따로 풀어 쓰는 이름은 없어요.
헷갈리기 쉬운 점: Kubernetes의 namespace는 리눅스 namespace가 아니다
컨테이너를 만드는 커널 기능에서 본 namespace는 커널이 프로세스마다 보이는 범위를 나누는 기능이었죠. Kubernetes에도 Namespace라는 리소스가 있는데, 이건 팀이나 환경별로 리소스를 묶어 두는 이름 구역입니다. 이름만 같고 전혀 다른 것이에요.
Pod는 Swarm의 태스크와 뭐가 다를까
Pod를 "≈ 태스크"라고 해 놓고 "컨테이너 묶음"이라고 했습니다. 왜 묶음일까요?
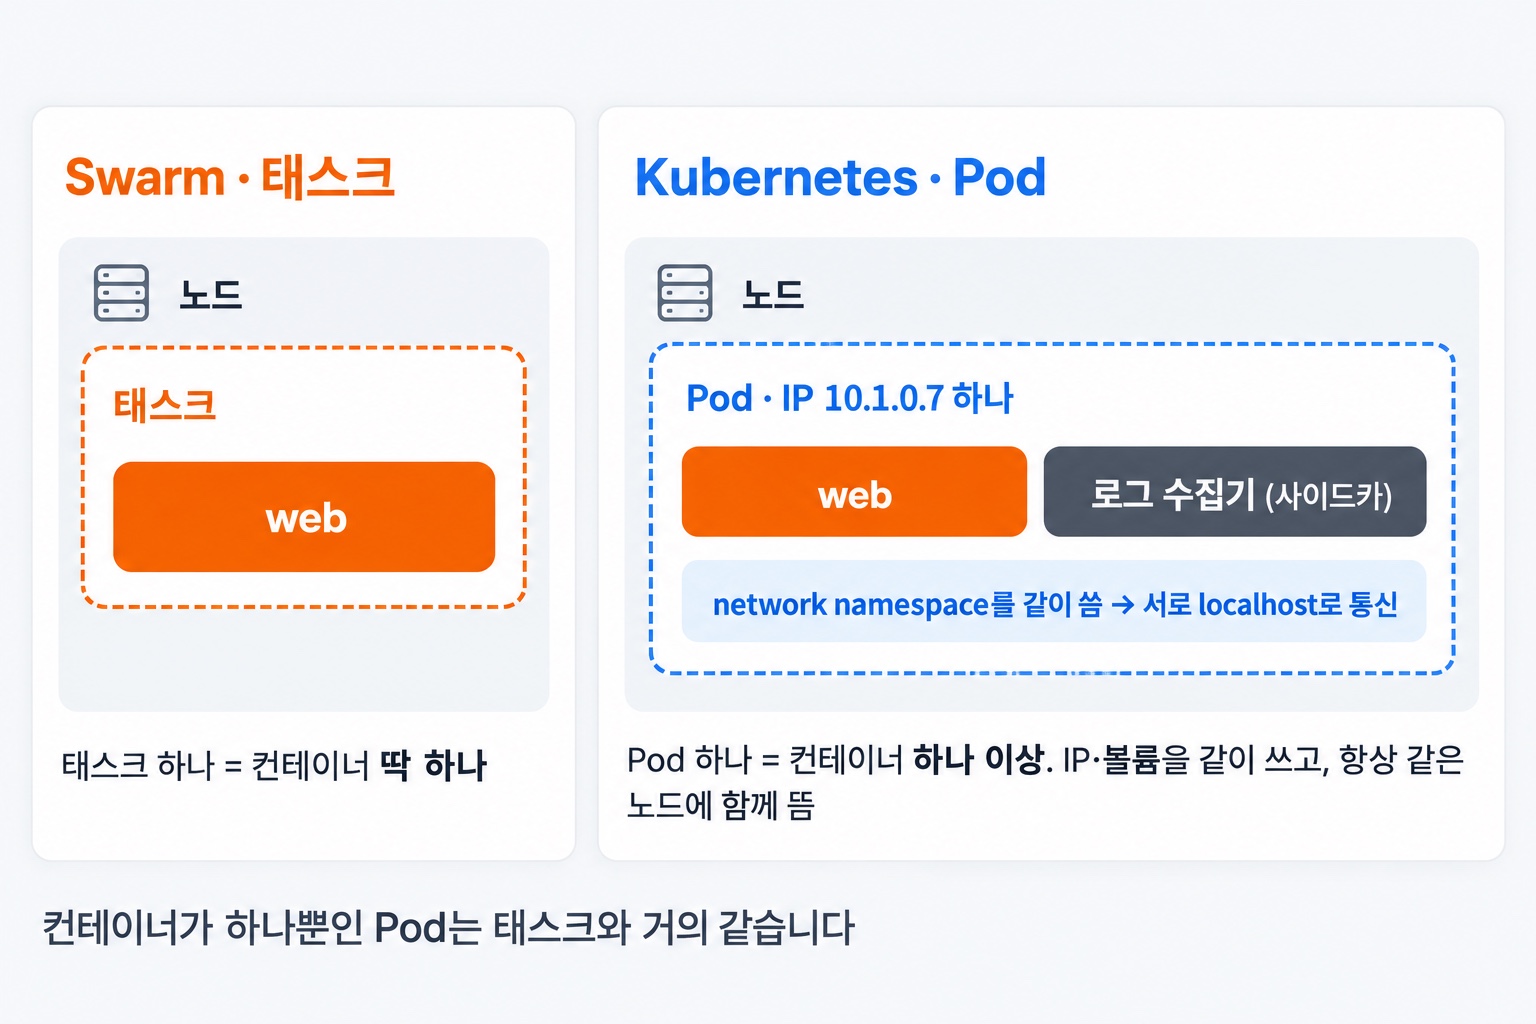
공통점부터 말하면, 태스크와 Pod는 둘 다 레플리카 하나의 자리입니다. 오케스트레이터가 노드에 배치하는 가장 작은 단위이고, 노드가 죽으면 그 자리를 다른 노드에 새로 만들어요. Swarm에는 Pod라는 말이 없고, 그 자리를 태스크라고 부릅니다.
차이는 안에 들어가는 컨테이너 수입니다.
- Swarm 태스크 하나에는 컨테이너가 항상 딱 하나입니다.
- Kubernetes Pod 하나에는 컨테이너가 하나 이상 들어갈 수 있어요. Pod 안의 컨테이너들은 network namespace를 같이 써서 IP가 하나이고, 서로
localhost로 통신합니다. 볼륨도 같이 쓸 수 있고, 항상 같은 노드에 함께 뜨고 함께 사라져요.
지난 글에서 컨테이너마다 network namespace를 따로 받아서 localhost도 각자 따로라고 했죠. Pod는 그 namespace를 일부러 같이 쓰게 묶은 겁니다. 그래서 주 컨테이너 옆에 로그 수집기나 프록시 같은 보조 컨테이너를 붙일 수 있고, 이런 보조 컨테이너를 사이드카라고 불러요. 내부적으로는 Pod를 만들 때 작은 pause 컨테이너가 먼저 떠서 namespace를 잡고 있고, 나머지 컨테이너가 그 namespace에 들어가는 방식입니다. 커널 기능의 조합이라 이런 묶음도 만들 수 있는 거예요.
다만 실무의 Pod는 대부분 컨테이너 하나입니다. 그럴 때는 Swarm의 태스크와 거의 같다고 생각해도 됩니다. 참고로 Pod라는 이름은 고래 떼(a pod of whales)에서 왔어요. Docker 로고가 고래라서요.
같은 앱을 세 도구로 띄워 보기
다루는 범위
| docker run | Compose | Swarm | Kubernetes | |
|---|---|---|---|---|
| 규모 | 컨테이너 1개 | 여러 개 | 여러 개 | 여러 개 |
| 대상 | 서버 1대 | 서버 1대 | 서버 여러 대 | 서버 여러 대 |
| 실행 단위 | 컨테이너 | 서비스 | 서비스 · 스택 | Pod · Deployment |
| 이름으로 찾으면 | 컨테이너 IP 1개 | 컨테이너 IP 여러 개 | 가상 IP 1개 | 가상 IP 1개 |
Compose까지는 서버 한 대, Swarm부터 서버 여러 대입니다. 마지막 줄을 보면 Compose는 서비스 이름으로 찾았을 때 컨테이너가 여러 개면 IP도 여러 개 돌려주고, 어느 걸 쓸지는 접속하는 쪽 몫이에요. Swarm과 Kubernetes는 가상 IP(VIP) 하나를 돌려주고, 그 IP로 온 요청을 뒤의 여러 컨테이너로 나눠 줍니다.
설정 파일
"nginx를 띄우고 밖에서 8080으로 접속"을 세 도구로 적어 보면 이렇습니다.
Compose:
services:
  web:
    image: nginx:alpine
    ports:
      - "8080:80"
Swarm은 같은 파일에 deploy 두 줄만 더합니다.
services:
  web:
    image: nginx:alpine
    ports:
      - "8080:80"
    deploy:
      replicas: 3
Compose 쪽에 replicas가 없는 이유가 있어요. 서버 한 대에서 컨테이너 세 개가 모두 8080번을 열 수는 없으니까요. Swarm은 8080으로 온 요청을 받아 세 컨테이너에 나눠 주는 장치(라우팅 메시)가 있어서 이대로 됩니다. 컨테이너가 없는 노드의 8080으로 들어와도 있는 노드로 넘겨 줘요.
Kubernetes는 하는 일마다 리소스를 나눠 적습니다. Deployment가 "Pod 3개 유지", Service가 "그 Pod들에게 요청을 나눠 주기"예요. 두 리소스를 ---로 나눠 파일 하나에 둘 수 있습니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: web
          image: nginx:alpine
          ports:
            - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  name: web
spec:
  type: NodePort
  selector:
    app: web
  ports:
    - port: 80
      nodePort: 30080
selector와 labels는 "어떤 Pod가 내 것인지"를 이름표로 찾는 부분이라 두 번 적게 됩니다. NodePort는 모든 노드의 특정 포트(30000~32767 중 하나)를 열어 주는 방식이라, Swarm이 모든 노드에 8080을 여는 것과 비슷해요. 도메인이나 경로로 나눠 받으려면 그때 Ingress나 Gateway API가 필요합니다.
길이만 보면 Swarm이 이기지만 꼭 단점은 아닙니다. 리소스가 나뉘어 있으면 Deployment는 개발팀이, Service와 네트워크는 인프라팀이 맡는 식으로 권한을 나누기 좋고, 일부만 갈아 끼우기도 쉽거든요. 실무에서는 이런 파일을 손으로 다 쓰기보다 Helm 같은 템플릿 도구로 만드는 경우가 많습니다.
운영할 때 해 주는 일
| docker run | Compose | Swarm | Kubernetes | |
|---|---|---|---|---|
| 스케일 아웃 | run을 직접 더 | 같은 서버 안에서만 | 레플리카 수만큼 노드에 분산 | 레플리카 + 자동 확장 (HPA) |
| 롤링 업데이트 | 없음 | 다시 만들기 (잠깐 끊김) | 하나씩, 조건을 걸어서 | 하나씩, 준비됐는지 확인하며 |
| 자가 치유 | 재시작 정책 | 재시작 정책 | 다른 노드에 다시 배치 | 다른 노드에 다시 배치 |
| 설정 방식 | 명령행 옵션 | YAML 파일 하나 | YAML 파일 하나 (거의 같음) | 리소스마다 YAML |
Compose와 Swarm은 서버가 죽어도 버티느냐에서 갈립니다. Swarm과 Kubernetes는 둘 다 버티는데, 얼마나 자동으로, 얼마나 세밀하게 해 주느냐에서 갈려요.
헷갈리기 쉬운 점: '새 것을 먼저 띄우는' 롤링 업데이트는 기본값이 아닐 수 있다
롤링 업데이트라고 하면 보통 "새 컨테이너를 띄우고, 준비되면 트래픽을 넘기고, 옛 것을 끈다"를 떠올립니다. Kubernetes Deployment는 기본이 이 순서예요. 그런데 Swarm의 기본값은 반대로 옛 것을 먼저 끄고 새 것을 띄우는(stop-first) 순서입니다. 레플리카가 하나뿐인 서비스라면 그 사이에 잠깐 끊겨요. 새 것을 먼저 띄우려면
deploy아래에 순서를 적어 줘야 합니다.yamldeploy: update_config: order: start-first
자주 쓰는 명령
| 하고 싶은 일 | Compose | Swarm | Kubernetes |
|---|---|---|---|
| 띄우기 | docker compose up -d |
docker stack deploy -c app.yml app |
kubectl apply -f app.yaml |
| 상태 보기 | docker compose ps |
docker stack services app |
kubectl get pods |
| 로그 보기 | docker compose logs web |
docker service logs app_web |
kubectl logs deploy/web |
| 개수 바꾸기 | docker compose up -d --scale web=3 |
docker service scale app_web=3 |
kubectl scale deploy/web --replicas=3 |
| 이미지 바꾸기 | 파일을 고치고 docker compose up -d |
docker service update --image nginx:1.27-alpine app_web |
kubectl set image deploy/web web=nginx:1.27-alpine |
| 지우기 | docker compose down |
docker stack rm app |
kubectl delete -f app.yaml |
Swarm에서는 서비스 이름 앞에 스택 이름이 붙습니다. app_web은 스택 app 안의 web 서비스라는 뜻이에요. 처음에 많이 헷갈리는 부분입니다. Swarm은 익숙한 docker 명령의 연장이고, Kubernetes는 kubectl이라는 새 명령을 배워야 하지만 그 하나로 모든 리소스를 같은 방식으로 다룹니다.
compose 파일을 스택으로 올릴 때
"deploy만 더하면 된다"고 했지만, 실제로 옮겨 보면 몇 가지가 걸립니다.
build는 무시됩니다. Swarm은 이미지를 직접 빌드하지 않아요. 서버가 여러 대면 노드마다 같은 이미지를 받아야 하니, 이미지를 레지스트리(Docker Hub, GHCR 등)에 먼저 올리고image로 적어야 합니다.depends_on과container_name도 무시됩니다. 띄우는 순서는 보장되지 않으니 앱이 DB 접속을 재시도하게 만들어야 하고, 컨테이너 이름은 Swarm이 붙입니다.- 예전 파일 맨 위의
version: "3.9"같은 줄은 요즘 compose에서는 필요 없어서, 적으면 더 이상 쓰지 않는다는 경고만 나와요.
노드 하나가 꺼지면
노드 세 대짜리 Swarm에서 자가 치유가 어떻게 보이는지 볼게요. (이 글의 출력은 모두 예시이고, 실제 docker service ps에 나오는 열 중 일부만 남겼습니다.)
docker service create --name web --replicas 3 -p 8080:80 nginx:alpine
docker service ps web
NAME    NODE    DESIRED STATE   CURRENT STATE
web.1   node1   Running         Running 2 minutes ago
web.2   node2   Running         Running 2 minutes ago
web.3   node3   Running         Running 2 minutes ago
우리가 노드를 고른 적이 없는데 manager가 하나씩 나눠 놓았습니다(스케줄링). 이제 node2의 전원을 끄고 다시 보면 이렇습니다.
NAME        NODE    DESIRED STATE   CURRENT STATE
web.1       node1   Running         Running 5 minutes ago
web.2       node3   Running         Running 20 seconds ago
 \_ web.2   node2   Shutdown        Running 5 minutes ago
web.3       node3   Running         Running 5 minutes ago
아무도 명령하지 않았는데 web.2가 node3에 다시 떴습니다. 앞에 \_가 붙은 줄은 node2에 있던 원래 web.2의 기록이에요. 원하는 상태(3개)와 실제 상태(2개)의 차이를 manager가 메운 겁니다.
node2가 다시 켜지면 어떻게 될까요? 노드가 되살아나는 것과 태스크가 돌아가는 건 별개입니다. 원래 태스크는 이미 Shutdown으로 정해져서 정리되고, Swarm은 노드가 돌아왔다고 태스크를 다시 고르게 옮기지 않아요. node3에 두 개, node2에 0개인 상태가 그대로 갑니다. 고르게 펴고 싶으면 docker service update --force web으로 다시 배치를 시킵니다.
노드를 끄는 실험은 서버가 여러 대여야 하지만, 자가 치유 자체는 Docker Desktop이나 서버 한 대에서도 볼 수 있어요. docker swarm init으로 노드 하나짜리 Swarm을 만들고 위의 서비스를 띄운 뒤, 태스크 컨테이너 하나를 docker rm -f로 지우고 docker service ps web을 다시 보면 새 태스크가 떠 있습니다. 다 보고 나면 docker swarm leave --force로 원래대로 돌아와요.
결국 커널이 한다
오케스트레이터가 바뀌어도 각 노드에서 실제로 일어나는 일은 지난 글과 같습니다. 설정 파일에 적은 값이 결국 어디에 적히는지 보면 분명해져요.
| 설정 파일에 적은 것 | 노드의 커널에서 일어나는 일 | 커널 기능 |
|---|---|---|
Swarm cpus: "1.0" |
cpu.max에 100000 100000 |
cgroup |
Swarm memory: 4G |
memory.max에 4294967296 |
cgroup |
Kubernetes limits.cpu: "1" |
cpu.max에 100000 100000 |
cgroup |
| Swarm overlay 네트워크 | 노드 사이 VXLAN 터널(UDP 4789) + 컨테이너마다 network namespace | VXLAN, namespace |
| Swarm 서비스 이름 → 가상 IP | 그 IP로 온 요청을 커널의 IPVS가 여러 컨테이너로 나눔 | IPVS |
cpus: "1.0"이 "CPU 코어 하나에 고정"이라는 뜻은 아닙니다. 지난 글에서 본 것처럼 0.1초마다 0.1초만큼, 즉 코어 하나만큼의 시간을 쓴다는 뜻이고, 그 시간은 여러 코어에 나눠 쓸 수 있어요. 특정 코어에 묶는 건 cpuset이라는 다른 설정입니다.
네트워크는 도구마다 조금 다릅니다. Swarm은 표의 VXLAN과 IPVS를 그대로 쓰지만, Kubernetes는 어떤 네트워크 플러그인(CNI)과 kube-proxy 설정을 고르느냐에 따라 달라요. 많이 쓰는 Flannel은 기본으로 VXLAN을 쓰지만 다른 방식을 쓰는 플러그인도 있고, kube-proxy는 iptables나 nftables로 요청을 나눕니다(IPVS 모드는 1.35에서 deprecated됐어요). 그래도 cgroup과 namespace는 어느 쪽이든 똑같이 씁니다.
정리하면 오케스트레이터는 어느 노드에 몇 개를 띄울지 정하는 관리자이고, 격리하고 제한하는 건 여전히 각 노드의 리눅스 커널입니다. Swarm으로 시작하든 Kubernetes로 시작하든, 이 부분을 이해해 두면 도구를 바꿔도 그대로 쓸 수 있어요.
무엇을 고를까
| 도구 | 이럴 때 |
|---|---|
| Docker Compose | 서버 한 대로 충분할 때. 개발 환경, 사이드 프로젝트, 배포 중 잠깐 끊겨도 괜찮을 때 |
| Docker Swarm | 서버 몇 대에 운영할 사람이 적을 때. 이미 compose 파일이 있고, 자동 확장보다 단순함이 중요할 때 |
| Kubernetes | 서비스와 팀이 많을 때. 자동 확장, 세밀한 권한, 넓은 생태계가 필요할 때. 매니지드(EKS·GKE·AKS)로 시작 |
배우는 순서로는 Compose를 충분히 써 보고, Swarm으로 '서버 여러 대'를 맛본 다음 Kubernetes로 가는 길도 괜찮습니다. 원하는 상태, 스케줄링, 서비스, 레플리카 같은 개념은 Kubernetes에서도 그대로 쓰이거든요. Kubernetes를 바로 익히고 싶다면 k3s나 작은 매니지드 클러스터로 시작하면 됩니다.
Swarm을 실제로 운영해 보면 Kubernetes와 어디서 갈리는지는 OCI 무료 자원을 노드 3개로 나눠 Swarm을 운영해 보니에 이어서 정리했습니다.
정리
- Compose는 서버 한 대 안에서 컨테이너 여러 개를 파일 하나로 띄웁니다.
- 서버가 여러 대가 되면 오케스트레이터가 스케줄링, 자가 치유, 롤링 업데이트, 서비스 디스커버리, 스케일링을 대신 해 줍니다.
- 오케스트레이터는 원하는 상태를 적어 두면 조정 루프로 계속 맞춰 줍니다.
- Swarm은 Docker에 들어 있고 compose 파일에
deploy만 더하면 됩니다. Kubernetes는 리소스가 잘게 나뉘어 복잡하지만 그만큼 세밀하고 생태계가 넓습니다. - 어느 쪽이든 격리와 제한은 각 노드의 커널이 합니다.